
একজন AI ডাক্তার কি আপনার রোগনির্ণয় ব্যাখ্যা করতে পারেন? এটি কী পারে এবং কী পারে না
হ্যাঁ — একজন AI ডাক্তার আপনার রোগনির্ণয় এবং ল্যাব ফলাফল সহজ ভাষায় ব্যাখ্যা করতে পারেন, কিন্তু এটি নিজে রোগনির্ণয় করতে বা তা নিশ্চিত করতে পারে না। আপনি যদি নিজে প্রক্রিয়াটি চেষ্টা করে দেখতে চান, তাহলে আপনি একজন AI ডাক্তারকে জিজ্ঞাসা করতে পারেন চিকিৎসা পরিভাষা অনুবাদ করতে, কোনো একটি টার্ম বা ল্যাব মানের অর্থ কী তা বলতে, এবং আপনার পরবর্তী অ্যাপয়েন্টমেন্টের জন্য প্রশ্ন প্রস্তুত করতে সাহায্য করতে। রোগনির্ণয়ের দায়িত্ব এখনও একজন লাইসেন্সপ্রাপ্ত চিকিৎসকের হাতেই থাকে, AI-এর নয়।
একজন AI ডাক্তার একজন লাইসেন্সপ্রাপ্ত চিকিৎসকের বিকল্প নয় এবং কোনো রোগনির্ণয় প্রদান করে না। চিকিৎসাগত জরুরি অবস্থার জন্য 911-এ কল করুন। এটিকে আপনার চিকিৎসা ফলাফলের একজন অনুবাদক হিসেবে ভাবুন, আপনার রোগনির্ণয় করা ডাক্তার হিসেবে নয়।
ব্যাখ্যা বনাম রোগনির্ণয়: সবচেয়ে গুরুত্বপূর্ণ সীমারেখা
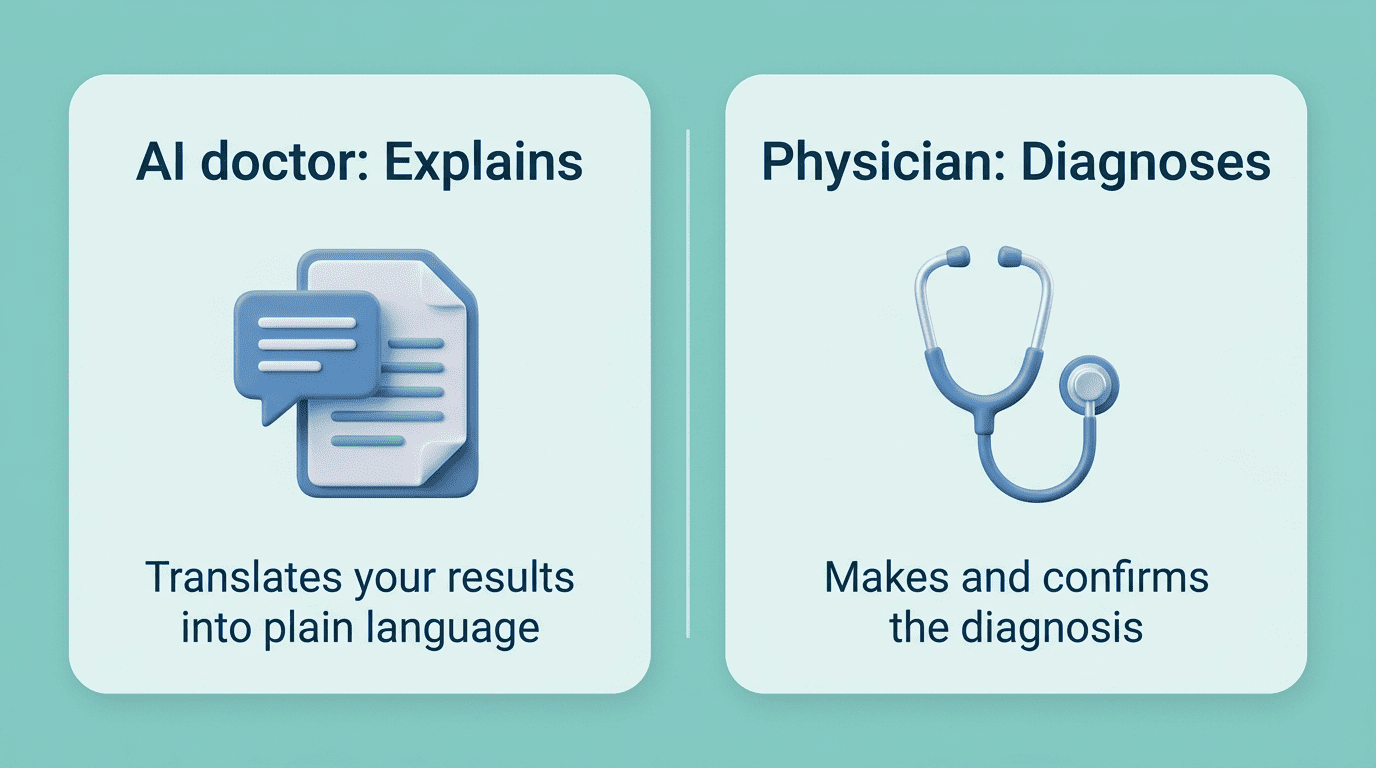
এই পুরো বিষয়ে সবচেয়ে কাজের পার্থক্যটি হলো ব্যাখ্যা করা এবং রোগনির্ণয় করার মধ্যকার ফারাক। একজন AI স্বাস্থ্য সহকারী প্রথমটি করার জন্য তৈরি; এটি স্পষ্টভাবেই দ্বিতীয়টি করার জন্য তৈরি নয়, আর যেসব টুল এটি ঠিকভাবে বোঝে সেগুলো কেউ পড়ে না এমন কোনো ডিসক্লেইমারে চাপা না দিয়ে বিষয়টি স্পষ্ট করে বলে দেয়।
“ব্যাখ্যা” মানে কী
ব্যাখ্যা করা মানে “আপনার HbA1c হলো 6.4% এবং আপনার ALT বেড়ে গেছে” — এটিকে এমন সহজ ভাষায় রূপান্তর করা যা আপনি আসলেই বুঝতে পারেন, এবং কোন মানগুলো স্বাভাবিক সীমার বাইরে এবং কেন সেগুলো গুরুত্বপূর্ণ তা বলা। Quest-এর AI Companion, একটি Google AI-চালিত চ্যাটবট, ঠিক এটিই করে: এটি সম্পন্ন ফলাফলগুলোর সারসংক্ষেপ করে, একটি পরীক্ষার উদ্দেশ্য ব্যাখ্যা করে, এবং ফলো-আপ প্রশ্নের উত্তর দেয় — ১৮ বছর ও তার বেশি বয়সী যে কারো জন্য, ২৪/৭, পাঁচ বছরের কম পুরনো হলে সর্বোচ্চ ২০টি সম্পন্ন ফলাফল জুড়ে উপলব্ধ।
একজন AI স্বাস্থ্য সহকারীর কাছ থেকে একটি সহজ-ভাষার ব্যাখ্যায় সাধারণত কয়েকটি ধারাবাহিক বিষয় থাকে:
- পরীক্ষাটি কী পরিমাপ করার জন্য তৈরি হয়েছিল, দৈনন্দিন ভাষায়
- প্রতিটি মান স্বাভাবিক রেফারেন্স সীমার ভিতরে, উপরে, নাকি নিচে অবস্থান করছে
- একটি মান বেড়ে যাওয়া বা কমে যাওয়ার সাধারণ, উদ্বেগহীন কারণ
- রিপোর্টে থাকা চিকিৎসা পরিভাষার সহজ-ভাষায় সংজ্ঞা
এর কোনোটিতেই ক্লিনিক্যাল বিচারবুদ্ধির প্রয়োজন হয় না — এটি অনুবাদ, আপনার নির্দিষ্ট কেসের ব্যাখ্যা-বিশ্লেষণ নয়, আর ঠিক এ কারণেই এটি সেই অংশ যা একজন AI ডাক্তার নির্ভরযোগ্যভাবে সামলাতে পারেন।
“রোগনির্ণয়” মানে কী — এবং কেন AI সেখানে থেমে যায়
রোগনির্ণয় করা মানে একজন রোগীর আসলে কোন রোগ হয়েছে এবং সে সম্পর্কে কী করতে হবে তা নির্ধারণ করা, এমন একটি বিচার যা একটি শারীরিক পরীক্ষা, একটি পূর্ণ ইতিহাস, এবং একটি চ্যাটবটের কাছে না থাকা ক্লিনিক্যাল অভিজ্ঞতার উপর নির্ভর করে। Quest-এর Companion স্পষ্টভাবে বলে দেয় যে এটি রোগনির্ণয় করতে, চিকিৎসার পরামর্শ দিতে, বা একজন প্রোভাইডারের বিকল্প হতে পারে না, এবং Stanford Medicine-এর সংস্করণটি আরও এক ধাপ এগিয়ে যায়: এর AI মেডিকেল রিপোর্ট বিশ্লেষক শুধুমাত্র একটি ব্যাখ্যার খসড়া তৈরি করে, যা এরপর একজন চিকিৎসক পর্যালোচনা করে অনুমোদন করেন রোগীর কাছে পৌঁছানোর আগেই।
সেই অতিরিক্ত পর্যালোচনা ধাপটি এই কারণে বিদ্যমান যে রোগনির্ণয়ের এমন পরিণতি থাকে যা একটি ব্যাখ্যার থাকে না। একটি সংজ্ঞা ভুল করলে তা একটি অসুবিধা মাত্র; একটি রোগনির্ণয় ভুল করলে তা মানে হতে পারে ভুল চিকিৎসা, একটি অসনাক্ত অবস্থা, বা যত্নে বিলম্ব — যা ঠিক সেই ঝুঁকি যা সামলানোর জন্য একজন লাইসেন্সপ্রাপ্ত চিকিৎসক প্রশিক্ষিত এবং আইনগতভাবে দায়বদ্ধ। একই সতর্কতা প্রযোজ্য যখন আপনি একজন AI ডাক্তারকে আপনার ওষুধ সম্পর্কে জিজ্ঞাসা করেন: এটি একটি ওষুধ কী করে তা ব্যাখ্যা করতে পারে, কিন্তু শুধুমাত্র একজন চিকিৎসকই আপনাকে বলা উচিত ডোজ শুরু করতে, বন্ধ করতে, বা পরিবর্তন করতে।
একজন AI ডাক্তার আসলে কীভাবে ফলাফল ব্যাখ্যা করেন
ভেতরের দিক থেকে, এই টুলগুলোর অধিকাংশই একই মৌলিক ধরন অনুসরণ করে — রিপোর্ট পড়া, ভাষাটিকে এমন কিছুতে মেলানো যা একজন অ-ক্লিনিশিয়ান অনুসরণ করতে পারেন, এবং কিছু প্রকাশ হওয়ার আগে একজন মানুষকে যুক্ত রাখা।
- আপনি একটি ল্যাব রিপোর্ট আপলোড বা পেস্ট করেন, যেখানে টুলটির প্রয়োজন হলে যত্ন প্রদানকারী বা স্ক্যানিং স্পষ্ট শনাক্তকারী তথ্য সরিয়ে ফেলার পরে।
- AI, একটি বৃহৎ ভাষা মডেলে চলমান, প্রতিটি পরীক্ষার নাম এবং সংখ্যাগত মান পার্স করে।
- এটি প্রতিটি মানকে মানসম্মত রেফারেন্স সীমার সাথে তুলনা করে কোনটি বেশি, কম, বা স্বাভাবিক তা চিহ্নিত করতে।
- এটি পরীক্ষাটি কী পরিমাপ করে এবং কেন একটি চিহ্নিত মান গুরুত্বপূর্ণ তার একটি সহজ-ভাষার বর্ণনা তৈরি করে।
- মানব-পর্যালোচিত সিস্টেমে, একজন চিকিৎসক খসড়া ব্যাখ্যাটি প্রকাশ হওয়ার আগে যাচাই করেন।
- আপনি ব্যাখ্যাটি মূল রিপোর্টের পাশাপাশি পান, তার পরিবর্তে নয়।
- আপনি ব্যাখ্যাটি ব্যবহার করেন আপনার ডাক্তারের জন্য প্রশ্ন লিখে রাখতে, চিকিৎসার সিদ্ধান্ত নিতে নয়।
এটি আপনার রিপোর্ট পড়ে এবং পরিভাষা অনুবাদ করে
আপনি একটি ফলাফল জমা দেওয়ার পরে, AI প্রতিটি টার্ম এবং মানকে ক্লিনিক্যাল সংক্ষিপ্তরূপের পরিবর্তে রেফারেন্স সীমা এবং দৈনন্দিন বর্ণনার সাথে মেলায়। TestResult.ai-এর মতো টুল, যা বলে যে এটি ৫০,০০০-এরও বেশি ল্যাব ফলাফল বিশ্লেষণ করেছে, ঠিক এই ধরনের সাধারণ রক্ত পরীক্ষার জন্য আপনার ল্যাব ফলাফল পড়তে ও ব্যাখ্যা করতে তৈরি, যাতে ব্যাখ্যাটি প্রকৃতপক্ষে বোধগম্য হয়, প্রযুক্তিগতভাবে সঠিক কিন্তু অকেজো না হয়।
এই টুলগুলো যেসব রিপোর্টের ধরন সবচেয়ে নির্ভরযোগ্যভাবে কভার করে তার মধ্যে রয়েছে:
- সম্পূর্ণ রক্ত গণনা (CBC)
- বিস্তৃত বিপাকীয় প্যানেল (CMP)
- থাইরয়েড ফাংশন পরীক্ষা
- লিপিড প্যানেল (কোলেস্টেরল)
- গ্লুকোজ এবং HbA1c ফলাফল
এই সাধারণ প্যানেলগুলোর বাইরে কভারেজ দ্রুত পাতলা হয়ে যায় — মানসম্মত রক্ত পরীক্ষার জন্য তৈরি একটি AI মেডিকেল রিপোর্ট বিশ্লেষকের কাছে একটি বিরল বা অতি-বিশেষায়িত পরীক্ষার জন্য অনেক কম প্রশিক্ষণ ডেটা থাকতে পারে — যা ব্যাখ্যাটিকে একটি চূড়ান্ত সিদ্ধান্তের পরিবর্তে একটি সূচনাবিন্দু হিসেবে বিবেচনা করার আরেকটি কারণ।

সেরা সংস্করণগুলো একজন মানুষকে প্রক্রিয়ায় যুক্ত রাখে
Stanford Medicine-এর AI ডায়াগনস্টিক সহকারী, Amazon Bedrock-এর মাধ্যমে চলমান Claude 3.5 Sonnet-এর উপর নির্মিত, একটি সহজ-ভাষার ব্যাখ্যার খসড়া তৈরি করে যা একজন প্রকৃত চিকিৎসক পর্যালোচনা করে অনুমোদন করেন রোগী তা দেখার আগেই — এটি কখনো স্বয়ংক্রিয়ভাবে পাঠানো হয় না। প্রকল্পটি ২৪ জনে সম্প্রসারিত হওয়ার আগে ১০ জন চিকিৎসক নিয়ে পাইলট চালানো হয়েছিল।
সেই মানব-প্রক্রিয়া-যুক্ত নকশাই হলো সেই স্বর্ণমান যার সাথে বাকি ক্ষেত্রটি এখনও তাল মিলিয়ে চলার চেষ্টা করছে: AI অনুবাদের কাজটি করে, এবং একজন ক্লিনিশিয়ান শব্দগুলো রোগীর কাছে পৌঁছানোর আগে সেগুলো অনুমোদন করেন। সেই পর্যালোচনা ধাপ ছাড়া টুলগুলো সংজ্ঞাগতভাবেই অনিরাপদ নয়, কিন্তু সেগুলো যাচাইয়ের বেশি দায়ভার আপনার উপর চাপিয়ে দেয় — যেকোনো একক AI ব্যাখ্যাকে একটি রায়ের পরিবর্তে একটি খসড়া হিসেবে বিবেচনা করার আরও একটি কারণ।
| টুল | এটি কী ব্যাখ্যা করে | আপনি দেখার আগে মানব পর্যালোচনা |
|---|---|---|
| Quest AI Companion | সম্পন্ন ল্যাব ফলাফল, পরীক্ষার উদ্দেশ্য | না — সরাসরি AI সারসংক্ষেপ, HIPAA-সম্মত |
| Stanford Medicine tool | পরীক্ষার ফলাফলের ব্যাখ্যা | হ্যাঁ — চিকিৎসক প্রতিটি ব্যাখ্যার খসড়া তৈরি করে অনুমোদন করেন |
| TestResult.ai | সাধারণ ল্যাব পরীক্ষা (CBC, থাইরয়েড, লিপিড, গ্লুকোজ) | না — স্বয়ংক্রিয়, সাধারণ-উদ্দেশ্যের চ্যাটবট |
এটি কতটা নির্ভুল — এবং কোথায় এটি ব্যর্থ হয়
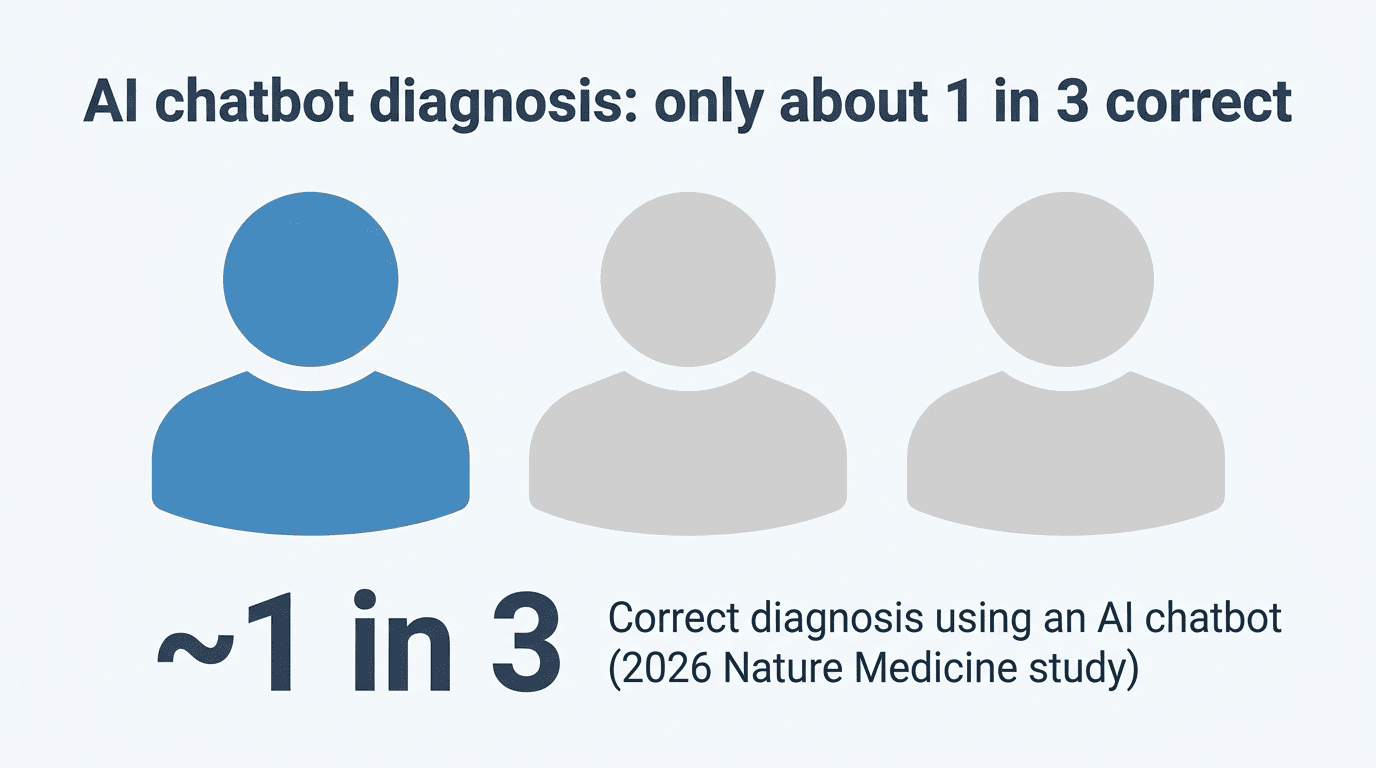
একটি একক টার্ম সঠিকভাবে ব্যাখ্যা করা একটি সঠিক রোগনির্ণয়ে পৌঁছানোর যুক্তি সাজানোর চেয়ে অনেক সহজ কাজ, এবং প্রতিটি কাজের জন্য নির্ভুলতার সংখ্যা খুবই ভিন্ন। একটি AI মেডিকেল সহকারী একটি টার্মের অর্থ ব্যাখ্যা করায় শক্তিশালী, কিন্তু নিজে থেকে একটি সঠিক সিদ্ধান্তে পৌঁছানোয় অনেক বেশি দুর্বল। Nature Medicine-এ প্রকাশিত একটি ২০২৬ সালের র্যান্ডমাইজড গবেষণায়, যারা তাদের উপসর্গ ব্যাখ্যা করতে একটি চ্যাটবট ব্যবহার করেছিলেন তারা সঠিক রোগনির্ণয়ে পৌঁছেছিলেন মাত্র প্রায় এক-তৃতীয়াংশ সময়, এবং Anthropic নিজেই বলে যে Claude “ক্লিনিক্যাল রোগনির্ণয় করার জন্য নকশা করা বা বাজারজাত করা হয়নি।” পরিভাষা ব্যাখ্যা করা এবং একটি নিরাপদ সিদ্ধান্তে পৌঁছানোর মধ্যকার সেই ফারাকই ঠিক সেই কারণ কেন ব্যাখ্যা-বনাম-রোগনির্ণয়ের সীমারেখাটি গুরুত্বপূর্ণ।
সেই সংখ্যাগুলোর পিছনের বাস্তব বিপদ হলো হ্যালুসিনেশন। একটি AI সম্পূর্ণ আত্মবিশ্বাসের সাথে একটি ভুল ব্যাখ্যা বলতে পারে, এবং এর সুরের কোনো কিছুই এই সংকেত দেয় না যে এটি ভুল হতে পারে — এটি ঠিক একটি সঠিক উত্তরের মতোই পড়া যায়। ব্যাপকভাবে রিপোর্ট করা একটি ঘটনায় ৭৫ বছর বয়সী এক ব্যক্তি জড়িত ছিলেন যিনি চিকিৎসাযোগ্য লিউকেমিয়ায় মারা যান, আংশিকভাবে খারাপ AI পরামর্শের ভিত্তিতে যত্ন প্রত্যাখ্যান করার পরে — যা একটি স্পষ্ট স্মারক যে গুরুত্বপূর্ণ যেকোনো কিছু একটি প্রকৃত, লাইসেন্সপ্রাপ্ত অনলাইন AI ডাক্তার পরিষেবা এবং একজন মানব চিকিৎসকের সাথে যাচাই করুন, দুটির যেকোনো একটির সাথে একা নয়।
জানা ব্যর্থতার বিন্দুগুলো কয়েকটি পুনরাবৃত্ত ধরনের চারপাশে ঘনীভূত হয়:
- কোনো দৃশ্যমান অনিশ্চয়তার সংকেত ছাড়া আত্মবিশ্বাসের সাথে দেওয়া ভুল উত্তর
- প্রশিক্ষণ ডেটায় কম প্রতিনিধিত্বকারী বিরল বা জটিল অবস্থা
- অনুপস্থিত প্রেক্ষাপট যা একটি AI কখনো পায়নি — পূর্ব ইতিহাস, শারীরিক পরীক্ষার ফলাফল, অন্যান্য ফলাফল
- ব্যবহারকারীরা একটি সহজ-ভাষার ব্যাখ্যাকে একটি সূচনাবিন্দুর পরিবর্তে একটি চূড়ান্ত রায় হিসেবে বিবেচনা করা
এর কোনোটিই একটি AI স্বাস্থ্য সহকারীকে অকেজো করে না — এটি একে ভাষা বোঝার একটি টুল করে তোলে, সিদ্ধান্ত নেওয়ার একটি টুল নয়।
কীভাবে একজন AI ডাক্তার নিরাপদে ব্যবহার করবেন
সঠিকভাবে ব্যবহার করলে, একজন AI ডাক্তার একটি ফলাফল পাওয়া এবং তা বোঝার মধ্যকার ফারাক কমিয়ে দেন। ভুলভাবে ব্যবহার করলে, এটি আপনাকে এমন যত্ন থেকে দূরে সরিয়ে দিতে পারে যা আপনার আসলেই প্রয়োজন।
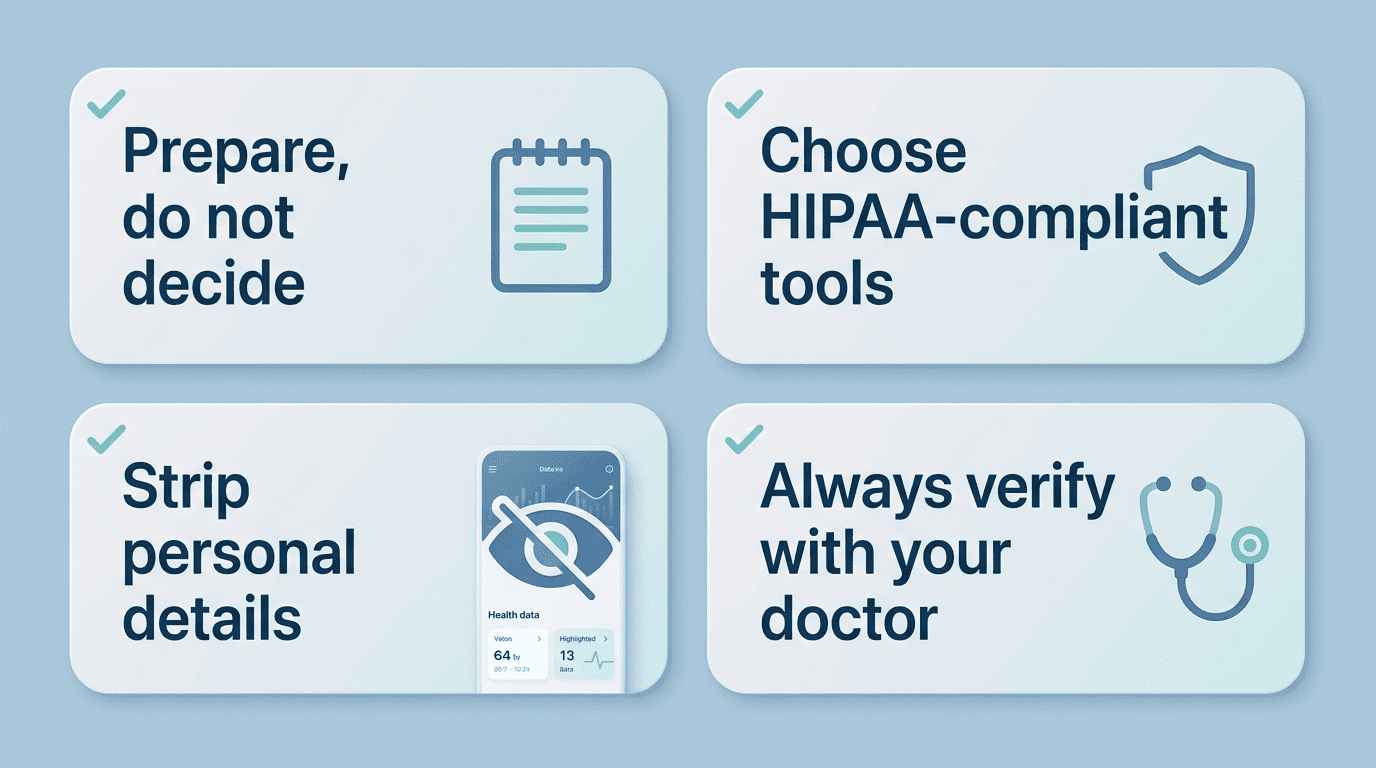
- এটি প্রস্তুত হতে ব্যবহার করুন, সিদ্ধান্ত নিতে নয়। 21st Century Cures Act-এর তথ্য-অবরোধ নিয়ম অনুযায়ী, ল্যাব ফলাফল আপনার কাছে তাৎক্ষণিকভাবে প্রকাশ করা হয় — প্রায়ই আপনার ডাক্তার এমনকি সেগুলো দেখার আগেই — যা একটি সংখ্যা অস্বাভাবিক দেখামাত্রই সিদ্ধান্তে ঝাঁপিয়ে পড়াকে প্রলুব্ধকর করে তোলে। AI ব্যবহার করুন টার্মগুলো বুঝতে এবং আপনার অ্যাপয়েন্টমেন্টের জন্য প্রশ্ন লিখে রাখতে, তারপর আপনার চিকিৎসককে ফলাফল ব্যাখ্যা করতে এবং পরবর্তীতে কী হবে তা নির্ধারণ করতে দিন।
- আপনার গোপনীয়তা রক্ষা করুন। এমন টুল পছন্দ করুন যা HIPAA সম্মতি ঘোষণা করে এবং নিশ্চিত করে যে তারা সর্বজনীন মডেল প্রশিক্ষণ দিতে আপনার ডেটা ব্যবহার করে না। একটি উদ্দেশ্য-নির্মিত মেডিকেল টুলের পরিবর্তে যখন একটি সাধারণ-উদ্দেশ্যের চ্যাটবট ব্যবহার করছেন তখন ব্যক্তিগত শনাক্তকারী তথ্য সরিয়ে ফেলুন।
- আপনার আচরণ পরিবর্তন করে এমন যেকোনো কিছু ক্রস-চেক করুন। মার্কিন প্রাপ্তবয়স্কদের প্রায় এক-তৃতীয়াংশ এখন স্বাস্থ্য প্রশ্নের জন্য বৃহৎ ভাষা মডেল ব্যবহার করেন, এবং ৪ কোটিরও বেশি মানুষ প্রতিদিন ChatGPT-কে স্বাস্থ্য প্রশ্ন জিজ্ঞাসা করেন — সেই স্কেলই ঠিক সেই কারণ কেন আপনি একটি অ্যাপয়েন্টমেন্ট বা একটি ওষুধ এড়িয়ে যাওয়ার আগে একটি দ্বিতীয়, মানব মতামত গুরুত্বপূর্ণ।
- আত্মবিশ্বাস-জাগানো ভুলের জন্য সতর্ক থাকুন। একটি AI হ্যালুসিনেশন ঠিক একটি সঠিক উত্তরের মতোই পড়া যায়, কিছু একটা গোলমেলে এমন কোনো অন্তর্নির্মিত সংকেত ছাড়াই; যদি একটি ব্যাখ্যা আপনার ডাক্তার আগে যা বলেছেন তার বিরোধিতা করে, তাহলে ডিফল্টভাবে নতুন উৎসটিকে বিশ্বাস করার পরিবর্তে সেটিকে চিহ্নিত করুন।
এই নিয়মগুলো একটি AI ডাক্তার কীসের জন্য ভালো এবং কীসের জন্য নয় তার একটি সরল বিভাজনে গিয়ে দাঁড়ায়:
| ভালো ব্যবহার | নিরাপদ ব্যবহার নয় |
|---|---|
| একটি টার্ম বা মানের অর্থ কী তা বোঝা | একটি চিকিৎসা শুরু বা বন্ধ করবেন কিনা তা সিদ্ধান্ত নেওয়া |
| একটি অ্যাপয়েন্টমেন্টের আগে নির্দিষ্ট প্রশ্ন প্রস্তুত করা | AI আত্মবিশ্বাসী মনে হয়েছিল বলে একটি ডাক্তারের ভিজিট এড়িয়ে যাওয়া |
| একটি নতুন ফলাফলের একটি সহজ-ভাষার প্রথম পাঠ পাওয়া | একটি একক AI উত্তরকে একটি চূড়ান্ত রোগনির্ণয় হিসেবে বিবেচনা করা |
| পরে নয়, বরং আগেই জিজ্ঞাসা করার জন্য কিছু চিহ্নিত করা | AI-এর বিরোধিতা করে বলে একজন ডাক্তারের পরামর্শ উপেক্ষা করা |
সেই টেবিলটি আসলে পুরো নিরাপত্তা মডেলটিকে এক জায়গায় ধারণ করে: বাম কলামটি হলো একটি AI স্বাস্থ্য সহকারী যা ভালো করে, ডান কলামটি হলো যেখানে একজন লাইসেন্সপ্রাপ্ত চিকিৎসককে দায়িত্ব নিতে হয়। কোনোটিই অপরটির বিকল্প নয়, এবং যেসব টুল সেই পার্থক্য সম্পর্কে সৎ, সেগুলোই আপনার নিজের ফলাফলের মতো এমন ব্যক্তিগত কিছু ভরসা করে দেওয়ার যোগ্য।
Anthropic, যে কোম্পানি Stanford Medicine-এর টুলকে চালিত করা Claude মডেলের পিছনে রয়েছে, সেই সীমারেখাটি কোথায় তা নিয়ে স্পষ্ট। এর ব্যবহার নীতি স্বাস্থ্যসেবা এবং চিকিৎসা রোগনির্ণয়কে একটি উচ্চ-ঝুঁকির ব্যবহারের ক্ষেত্র হিসেবে তালিকাভুক্ত করে যার জন্য কোনো আউটপুট ব্যবহারের আগে যোগ্য মানব পর্যালোচনা প্রয়োজন, এবং কোম্পানির একজন মুখপাত্র একই কথা সহজ ভাষায় বলেছেন:
Claude ক্লিনিক্যাল রোগনির্ণয় করার জন্য নকশা করা বা বাজারজাত করা হয়নি।Anthropic spokesperson, quoted in Scientific American
সমাপনী নিরাপত্তা নোট
একজন AI ডাক্তার একজন লাইসেন্সপ্রাপ্ত চিকিৎসকের বিকল্প নয় এবং কোনো রোগনির্ণয় প্রদান করে না। চিকিৎসাগত জরুরি অবস্থার জন্য 911-এ কল করুন। যেকোনো ব্যাখ্যা অনুসারে কাজ করার আগে সর্বদা একজন প্রকৃত, লাইসেন্সপ্রাপ্ত ডাক্তারের সাথে তা নিশ্চিত করুন — একজন AI ডাক্তার আপনার ফলাফলের ভাষা অনুবাদ করতে পারেন, কিন্তু শুধুমাত্র একজন চিকিৎসকই তা একটি রোগনির্ণয় এবং একটি চিকিৎসা পরিকল্পনায় রূপান্তর করতে পারেন।