
AI 医生能解释你的诊断吗?它能做什么,不能做什么
能——AI 医生可以用通俗的语言解释你的诊断和化验结果,但它无法自行做出或确认诊断。如果你想亲自试一试这个过程,你可以询问一位 AI 医生来翻译医学术语、告诉你某个术语或化验数值的含义,并帮助你为下一次就诊准备问题。诊断的最终决定权仍然属于持证医生,而不是 AI。
AI 医生不能替代持证医生,也不提供诊断。如遇医疗紧急情况,请拨打 911。 请把它看作是解读你医疗结果的翻译器,而不是为你做诊断的医生。
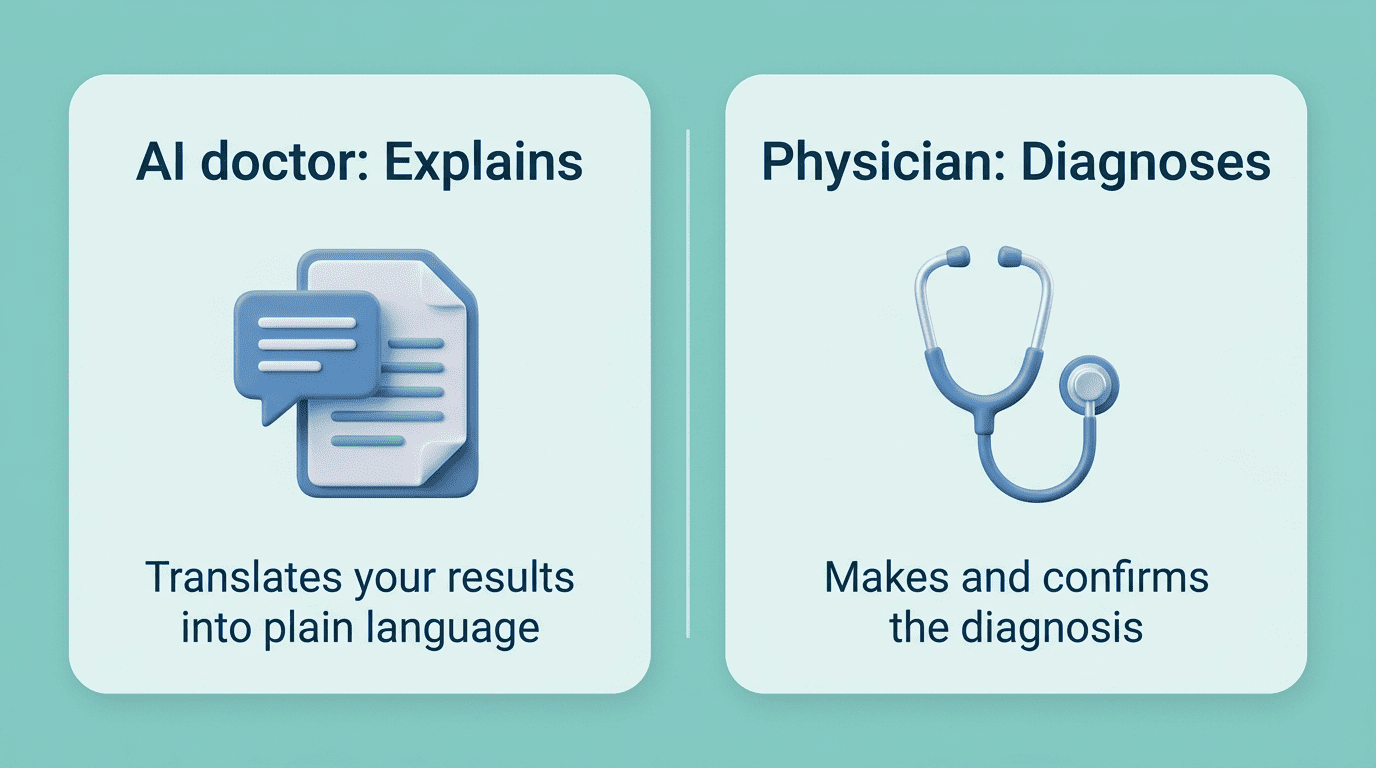
解释与诊断:最关键的那条界线
在整个话题中,最有用的一个区分就是”解释”和”诊断”之间的差距。AI 健康助手的设计目的是做前者;它明确不是为做后者而设计的,而那些做对了这一点的工具会大大方方地说出来,而不是把它埋在没人看的免责声明里。
“解释”是什么意思
解释指的是把”你的糖化血红蛋白(HbA1c)是 6.4%,你的丙氨酸转氨酶(ALT)偏高”转化成你真正能看懂的通俗语言,并告诉你哪些数值超出了范围以及为什么这些数值重要。Quest 的 AI Companion 是一款由 Google AI 驱动的聊天机器人,做的正是这件事:它汇总已完成的检测结果、解释某项检测的目的,并回答后续问题——面向所有 18 岁及以上的人开放,全天候可用,可覆盖多达 20 份五年以内的已完成结果。
来自 AI 健康助手的通俗语言解释通常涵盖几件一致的事:
- 用日常用语说明这项检测原本是用来测量什么的
- 每个数值是位于正常参考范围之内、之上还是之下
- 某个数值偏高或偏低的常见、无需惊慌的原因
- 对报告上出现的医学术语给出通俗易懂的定义
这些都不需要临床判断——它是翻译,而不是对你具体病例的解读,这正是 AI 医生能够可靠处理的部分。
“诊断”是什么意思——以及 AI 为什么止步于此
诊断指的是判断一位患者实际患有什么疾病以及该如何应对,这是一种依赖于体格检查、完整病史和聊天机器人无法获得的临床经验的判断。Quest 的 Companion 明确表示它无法做诊断、推荐治疗或替代医疗提供者,而斯坦福医学院(Stanford Medicine)的版本则更进一步:它的 AI 医疗报告分析器只起草一份解释,随后由医生审阅并批准,才会送达患者。
之所以要有这个额外的审阅步骤,是因为诊断带来的后果是解释所没有的。把一个定义搞错只是带来不便;把诊断搞错则可能意味着错误的治疗、漏诊或延误治疗——这正是持证医生受过训练、并在法律上负责去管理的风险。当你向 AI 医生咨询你的用药时,同样需要谨慎:它可以解释某种药物的作用,但只有医生才应该告诉你开始、停止或调整剂量。
AI 医生实际上是如何解释结果的
在底层,大多数这类工具都遵循同样的基本模式——读取报告、把语言匹配到非临床人员能看懂的程度,并在任何东西发出之前始终让人参与其中。
- 你上传或粘贴一份化验报告,在工具要求时由医疗提供者或扫描去除明显的身份标识信息之后。
- 运行在大语言模型上的 AI 解析每一个检测项目名称和数值。
- 它将每个数值与标准参考范围进行对照,以标记哪些偏高、偏低或正常。
- 它生成一段通俗语言的描述,说明这项检测测量的是什么,以及为什么被标记的数值很重要。
- 在有人工审阅的系统中,医生会在解释发布之前检查草稿。
- 你收到的是解释连同原始报告,而不是用它取代原始报告。
- 你用这份解释来写下要问医生的问题,而不是用来决定治疗。
它读取你的报告并翻译术语
一旦你提交结果,AI 就会把每个术语和数值匹配到参考范围和日常描述,而不是临床速记。像 TestResult.ai 这样的工具(它称自己已分析了超过 50,000 份化验结果)正是为了读取并解释你的化验结果而构建,专门应对这类常见的血液检查,因此这份解释是真正可以理解的,而不是技术上准确却毫无用处。
这些工具覆盖得最可靠的报告类型包括:
- 全血细胞计数(CBC)
- 综合代谢功能检查(CMP)
- 甲状腺功能检测
- 血脂检查(胆固醇)
- 血糖和糖化血红蛋白(HbA1c)结果
一旦超出这些常见的检查项目,覆盖范围往往会迅速变薄——一款为标准血液检查而构建的 AI 医疗报告分析器,对于罕见或高度专业化的检测可能拥有的训练数据要少得多,这也是把这份解释当作起点而非定论的另一个原因。

最好的版本会让人参与其中
斯坦福医学院的 AI 诊断助手基于运行在 Amazon Bedrock 上的 Claude 3.5 Sonnet 构建,它起草一份通俗语言的解读,在患者看到之前由一位真正的医生审阅并批准——它绝不会被自动发送。该项目先与 10 位医生进行试点,随后扩展到 24 位。
那种让人参与其中(human-in-the-loop)的设计是这个领域其他部分仍在追赶的黄金标准:AI 负责翻译,而临床医生在文字送达患者之前签字确认。没有那道审阅步骤的工具并不一定就是不安全的,但它们把更多的核实负担转移到了你身上——这又是一个把任何单一 AI 解释当作草稿而非定论的理由。
| 工具 | 它解释什么 | 你看到之前是否有人工审阅 |
|---|---|---|
| Quest AI Companion | 已完成的化验结果、检测目的 | 否——直接由 AI 汇总,符合 HIPAA |
| 斯坦福医学院工具 | 检测结果解读 | 是——医生起草并批准每一份解释 |
| TestResult.ai | 常见化验项目(CBC、甲状腺、血脂、血糖) | 否——自动化、通用型聊天机器人 |
它有多准确——以及它在哪里会失败
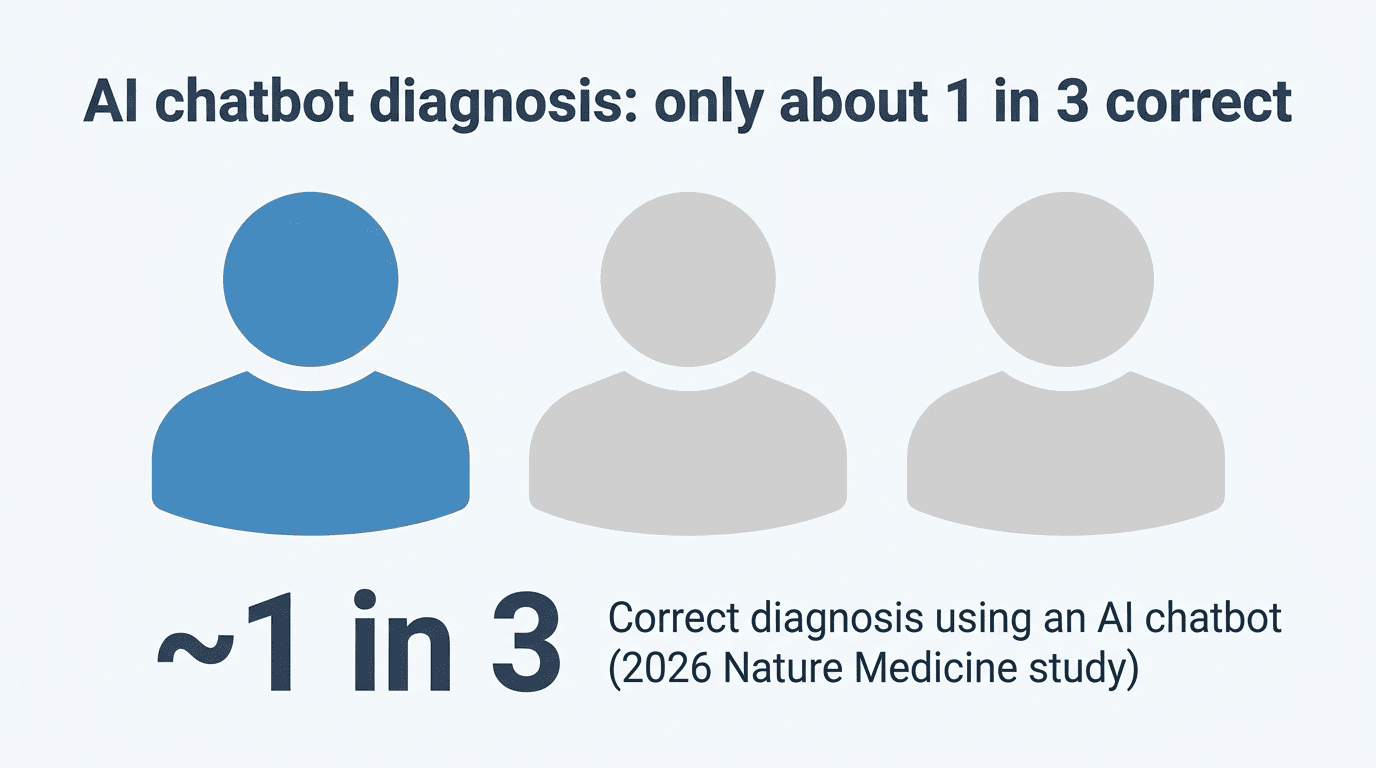
正确解释单个术语,是一项比推理出正确诊断容易得多的任务,而这两项任务的准确率数字非常不同。AI 医疗助手在解释某个术语的含义方面很强,但在独自得出正确结论方面则弱得多。在一项发表于《自然·医学》(Nature Medicine)的 2026 年随机研究中,使用聊天机器人来解读自身症状的人只有大约三分之一的时候得出了正确诊断,而 Anthropic 自己也表示 Claude”并非为做出临床诊断而设计或推广”。解释术语与得出安全结论之间的这种差距,正是”解释与诊断”这条界线之所以重要的原因。
幻觉(hallucination)是这些数字背后实际的危险。AI 可以以十足的自信陈述一个错误的解释,而它的语气丝毫不会提示它可能是错的——它读起来和一个正确答案一模一样。一个被广泛报道的案例涉及一位 75 岁的老人,他部分因为听信了糟糕的 AI 建议而拒绝治疗,最终死于本可治疗的白血病,这个惨痛的提醒告诉我们:任何重要的事情都要用真正持证的在线 AI 医生服务和一位人类医生来核实,而不是只靠其中任何一个。
已知的失败点集中在几种反复出现的模式上:
- 自信满满却错误的答案,且没有可见的不确定性信号
- 在训练数据中被代表不足的罕见或复杂病症
- 缺失 AI 从未拥有的背景信息——既往病史、体格检查所见、其他结果
- 用户把通俗语言的解释当作最终定论,而不是起点
这些都不会让 AI 健康助手变得毫无用处——它让 AI 成为一个理解语言的工具,而不是一个做出判断的工具。
如何安全地使用 AI 医生
用得对,AI 医生会缩短从拿到结果到理解结果之间的差距。用得不对,它可能会劝你放弃你实际需要的治疗。
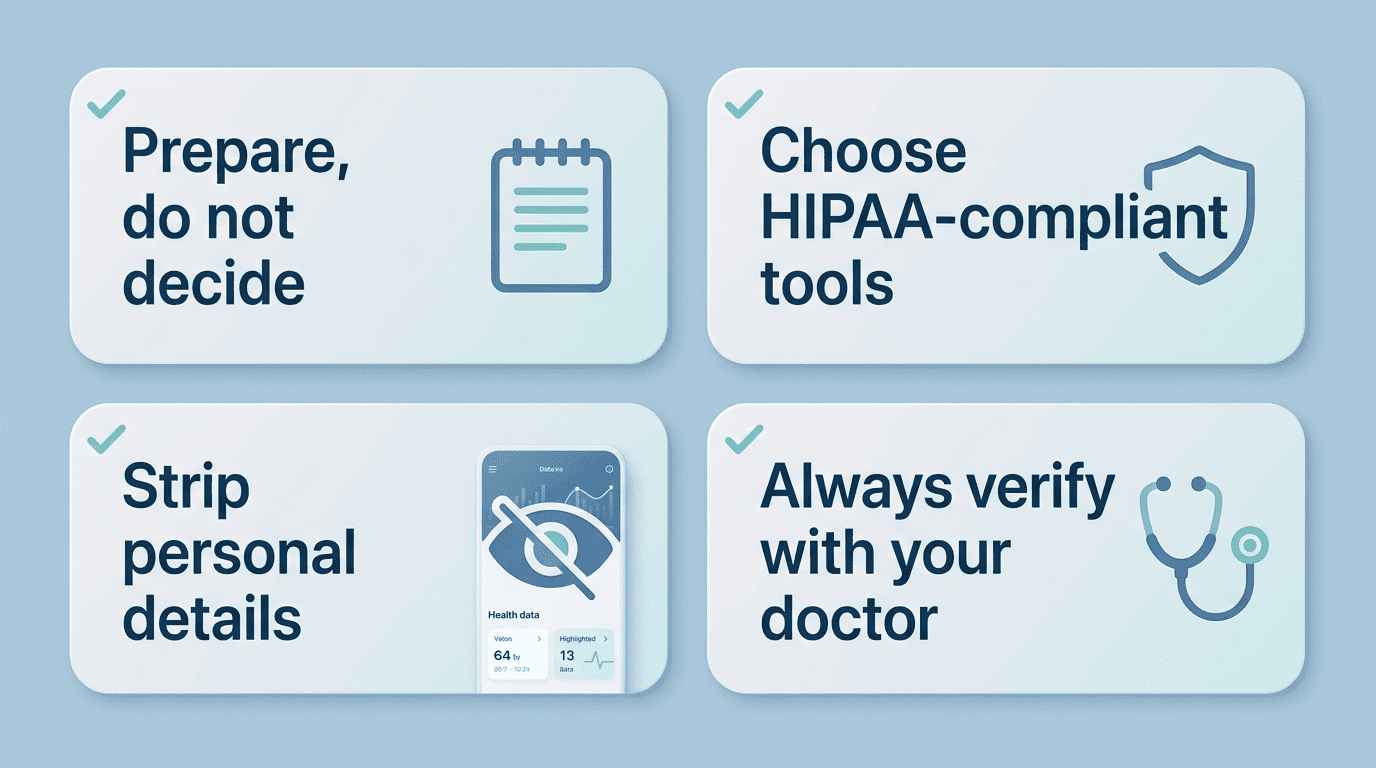
- 用它来准备,而不是用来决定。 根据《21 世纪治愈法案》的信息屏蔽规则,化验结果会立即向你公布——往往在你的医生都还没看到之前——这就让人一看到某个数字异常就忍不住急于下结论。用 AI 来理解术语并写下要在就诊时问的问题,然后让你的医生去解读结果并决定接下来该怎么办。
- 保护你的隐私。 优先选择声明符合 HIPAA 合规的工具,并确认它们不会用你的数据来训练公开模型。当你使用通用型聊天机器人而非专门打造的医疗工具时,请去除个人身份标识信息。
- 对任何会改变你行为的事情进行交叉核对。 如今大约三分之一的美国成年人使用大语言模型来问健康问题,每天有超过 4000 万人向 ChatGPT 询问健康问题——正是这种规模,使得在你跳过一次就诊或一次用药之前,来自人类的第二意见变得重要。
- 警惕听起来很自信的错误。 AI 幻觉读起来和正确答案一模一样,没有内置的信号提示有什么不对劲;如果一份解释与你的医生已经告诉你的话相矛盾,请把它标记出来,而不是默认相信更新的那个来源。
这些规则归结为一个简单的划分:AI 医生擅长做什么,不擅长做什么:
| 好的用途 | 不安全的用途 |
|---|---|
| 理解某个术语或数值的含义 | 决定是否开始或停止一项治疗 |
| 在就诊前准备具体的问题 | 因为 AI 看起来很自信就跳过看医生 |
| 对一个新结果获得通俗语言的初步解读 | 把单一的 AI 回答当作最终诊断 |
| 把某件事标记出来以便尽早询问 | 因为医生的建议与 AI 相矛盾就忽视它 |
那张表其实把整个安全模型集中在了一处:左栏是 AI 健康助手做得好的事,右栏是持证医生必须接手的地方。两者谁也不能替代谁,而那些对这一区分诚实以对的工具,才是值得你把像自己的化验结果这样私密的东西托付给它们的。
Anthropic 是驱动斯坦福医学院工具的 Claude 模型背后的公司,它对这条界线所在的位置直言不讳。它的使用政策将医疗保健和医学诊断列为高风险用例,要求在使用任何输出之前经过合格的人工审阅,而一位公司发言人也用通俗的语言表达了同样的观点:
Claude 并非为做出临床诊断而设计或推广。 — Anthropic 发言人,引自《科学美国人》(Scientific American)
结尾安全提示
AI 医生不能替代持证医生,也不提供诊断。如遇医疗紧急情况,请拨打 911。 在采取任何行动之前,务必用一位真正持证的医生来确认任何解释——AI 医生可以翻译你结果的语言,但只有医生才能把它转化为诊断和治疗方案。