
AIドクターはあなたの診断を説明できるのか?できることとできないこと
はい――AIドクターはあなたの診断や検査結果を平易な言葉で説明できますが、診断そのものを下したり確定したりすることはできません。自分でこのプロセスを試したい場合は、AIドクターに質問することで、医学用語を翻訳してもらったり、ある用語や検査値が何を意味するのかを教えてもらったり、次の診察に向けた質問を準備する手助けをしてもらえます。診断を担うのは依然として資格を持つ医師であって、AIではありません。
AIドクターは資格を持つ医師の代わりにはならず、診断を提供するものではありません。医療上の緊急時には911に電話してください。AIドクターは、あなたを診断する医師ではなく、あなたの検査結果の翻訳者だと考えてください。
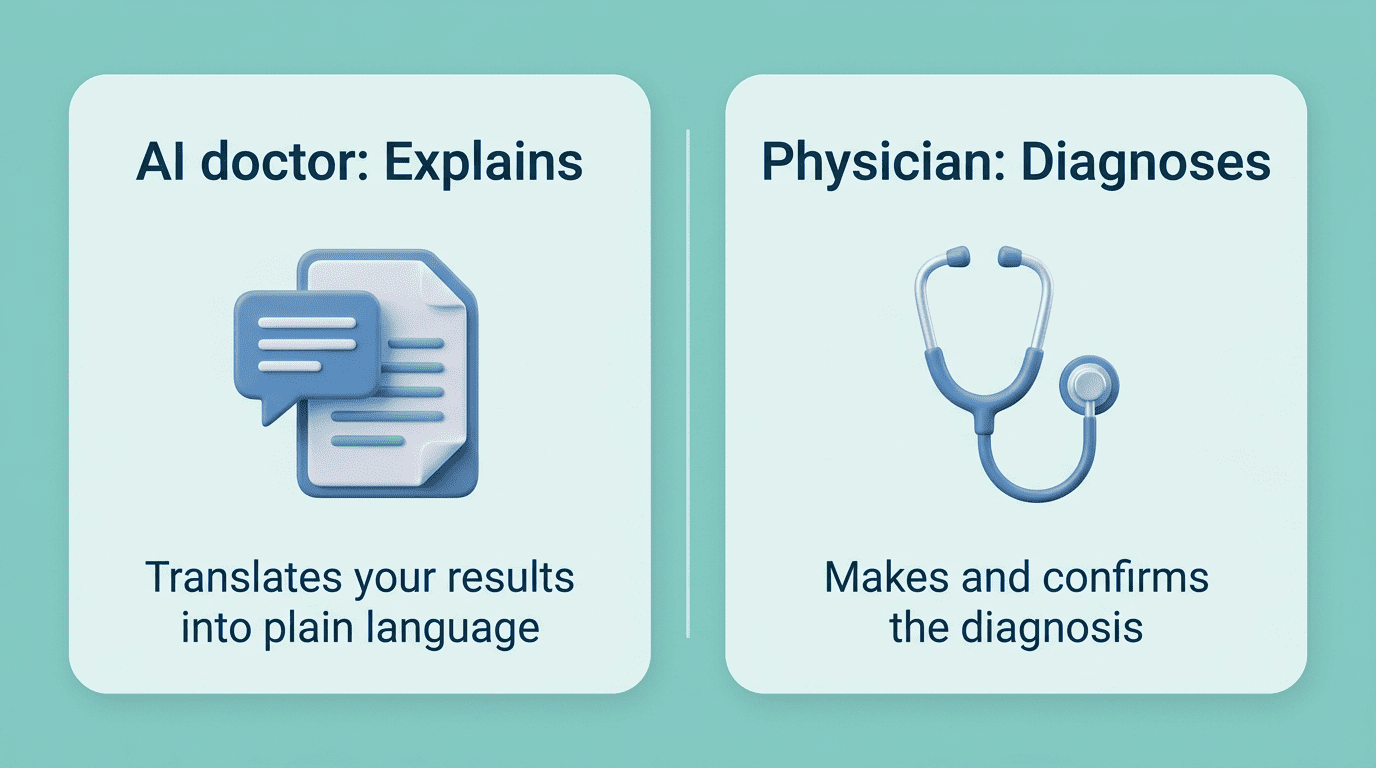
説明する vs. 診断する:最も重要な境界線
このテーマ全体で最も役立つ区別は、説明することと診断することの間にある溝です。AIヘルスアシスタントは前者を行うために作られており、後者を行うためには明確に作られていません。そして、この点を正しく扱うツールは、誰も読まない免責事項の中に埋め込むのではなく、はっきりと声に出してそう述べています。
「説明する」とはどういう意味か
説明するとは、「あなたのHbA1cは6.4%で、ALTが高値です」といった内容を、実際に理解できる平易な言葉に変え、どの値が基準範囲外でなぜそれが重要なのかを伝えることです。Google AIを活用したチャットボットであるQuestのAI Companionは、まさにこれを行います。完了した検査結果を要約し、検査の目的を説明し、追加の質問に答えます――18歳以上であれば誰でも、24時間いつでも利用でき、5年以内であれば最大20件の完了した検査結果に対応します。
AIヘルスアシスタントによる平易な言葉での説明は、通常いくつかの一貫した内容をカバーします。
- その検査が何を測定するために設計されたのか、日常的な言葉で
- 各値が正常な基準範囲の内側にあるか、上回っているか、下回っているか
- 値が高くなったり低くなったりする、よくある心配のいらない理由
- 報告書に現れる医学用語の平易な言葉による定義
これらのいずれも臨床的判断を必要としません――これはあなた個別のケースの解釈ではなく翻訳であり、まさにそれこそがAIドクターが確実に扱える部分なのです。
「診断する」とはどういう意味か――そしてなぜAIはそこで止まるのか
診断するとは、患者が実際にどんな病気を抱えているのか、そしてそれに対して何をすべきかを決定することであり、それは身体診察、完全な病歴、そしてチャットボットがアクセスできない臨床経験に依存する判断です。QuestのCompanionは、診断すること、治療を推奨すること、あるいは医療提供者の代わりになることはできないとはっきり述べており、Stanford Medicineのバージョンはさらに一歩踏み込んでいます。そのAI医療報告書アナライザーは説明の下書きを作成するだけで、それを医師が確認して承認してから患者に届けられます。
その追加の確認ステップが存在するのは、診断には説明にはない結果責任が伴うからです。定義を間違えるのは不便で済みますが、診断を間違えれば、誤った治療、見逃された疾患、あるいはケアの遅れを意味しかねません――まさにそれが、資格を持つ医師が訓練を受け、法的に責任を負って管理するリスクです。薬についてAIドクターに質問するときにも同じ注意が当てはまります。AIは薬が何をするのかを説明できますが、開始・中止・用量変更を指示できるのは医師だけです。
AIドクターが実際にどのように結果を説明するのか
内部の仕組みとしては、これらのツールのほとんどが同じ基本的なパターンに従っています――報告書を読み取り、非臨床家が理解できる言葉に合わせ、何かが送り出される前に必ず人間を関与させる、というものです。
- ツールが要求する場合には、医療提供者やスキャン処理によって明白な識別情報が取り除かれた後、あなたが検査報告書をアップロードまたは貼り付けます。
- 大規模言語モデル上で動作するAIが、各検査名と数値を解析します。
- 各値を標準的な基準範囲と比較し、高値・低値・正常のいずれかを識別します。
- その検査が何を測定するのか、そして識別された値がなぜ重要なのかを平易な言葉で記述します。
- 人間による確認を行うシステムでは、公開前に医師が説明の下書きを確認します。
- あなたは元の報告書の代わりにではなく、報告書とともに説明を受け取ります。
- あなたはその説明を、治療を決めるためではなく、医師への質問を書き留めるために使います。
報告書を読み取り、専門用語を翻訳する
結果を送信すると、AIは各用語や値を臨床的な略語ではなく基準範囲や日常的な説明に対応づけます。5万件以上の検査結果を分析してきたと述べるTestResult.aiのようなツールは、まさにこの種のよくある血液検査について検査結果を読み取り説明するために作られています。そのため説明は、技術的には正確でも役に立たないものではなく、本当に理解できるものになります。
これらのツールが最も確実にカバーする報告書の種類には、以下が含まれます。
- 全血球計算(CBC)
- 包括的代謝パネル(CMP)
- 甲状腺機能検査
- 脂質パネル(コレステロール)
- 血糖値とHbA1cの結果
これらの一般的なパネルの外では、カバー範囲は急速に薄くなる傾向があります――標準的な血液検査向けに作られたAI医療報告書アナライザーは、まれな検査や高度に専門化された検査については学習データがはるかに少ない可能性があり、これもまた説明を最終結論ではなく出発点として扱うべきもう一つの理由です。

最良のバージョンは人間を関与させ続ける
Amazon Bedrockを介して動作するClaude 3.5 Sonnet上に構築されたStanford MedicineのAI診断アシスタントは、平易な言葉による解釈の下書きを作成し、それを実際の医師が確認・承認してから初めて患者に見せます――自動送信されることは決してありません。このプロジェクトは10人の医師で試験運用を行った後、24人に拡大しました。
その「人間を介在させる(human-in-the-loop)」設計こそ、この分野の他の部分がいまだ追いつこうとしているゴールドスタンダードです。AIが翻訳を行い、言葉が患者に届く前に臨床家が承認します。その確認ステップのないツールが定義上ただちに危険というわけではありませんが、検証の負担のより多くをあなたに移すことになります――これもまた、単一のAIによる説明を最終結論ではなく下書きとして扱うべきもう一つの理由です。
| ツール | 説明する内容 | あなたが見る前の人間による確認 |
|---|---|---|
| Quest AI Companion | 完了した検査結果、検査の目的 | なし――直接的なAI要約、HIPAA準拠 |
| Stanford Medicineのツール | 検査結果の解釈 | あり――医師がすべての説明を下書きし承認 |
| TestResult.ai | 一般的な検査(CBC、甲状腺、脂質、血糖) | なし――自動化された汎用チャットボット |
どれほど正確なのか――そしてどこで失敗するのか
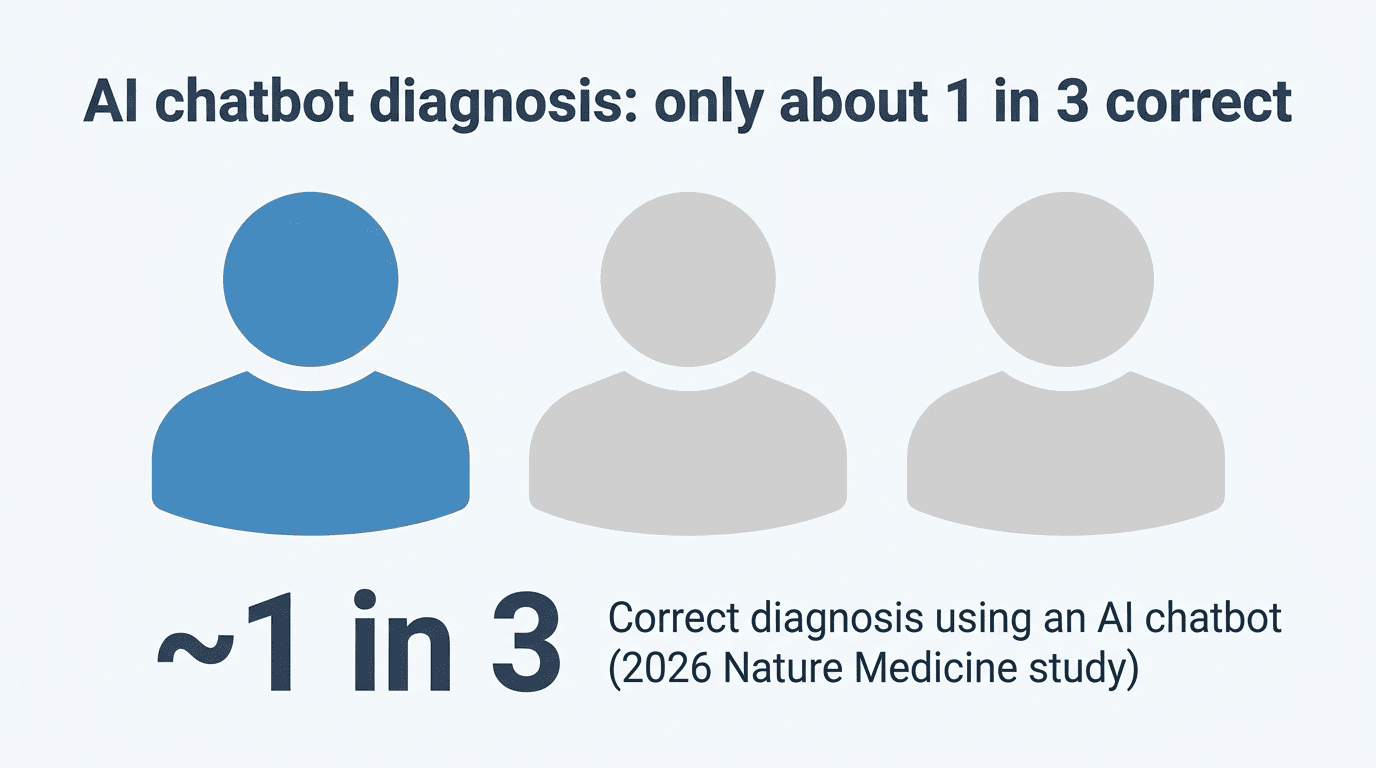
一つの用語を正しく説明することは、正しい診断へと推論を進めることよりもはるかに簡単な作業であり、それぞれの作業の正確性の数字は大きく異なります。AI医療アシスタントは用語が何を意味するのかを説明することには強いものの、自力で正しい結論に到達することにははるかに弱いのです。Nature Medicineに掲載された2026年のランダム化研究では、症状を解釈するためにチャットボットを使った人々が正しい診断に到達したのはおよそ3分の1の場合だけでした。そしてAnthropic自身も、Claudeは「臨床診断を下すために設計されたりマーケティングされたりしているわけではない」と述べています。用語を説明することと安全な結論を導くことの間にあるその溝こそ、まさに説明と診断の境界線が重要である理由です。
それらの数字の背後にある実際的な危険はハルシネーション(作話)です。AIは誤った説明を完全な自信をもって述べることがあり、その口調のどこにも間違っているかもしれないという合図はありません――それはまさに正しい答えのように読めてしまいます。広く報道されたある事例では、75歳の男性が、部分的に誤ったAIの助言を頼りにケアを拒否した後、治療可能な白血病で亡くなりました。これは、重要なことは何であれ、本物で資格を持つオンラインAIドクターサービスと人間の医師の両方で確認すべきであって、どちらか一方だけに頼るべきではないという痛烈な戒めです。
知られている失敗の要点は、いくつかの繰り返し現れるパターンに集約されます。
- 不確実性を示す合図がまったくないまま、自信をもって誤った答えを出す
- 学習データで十分に表現されていない、まれで複雑な病態
- AIがそもそも持っていなかった文脈の欠落――既往歴、身体診察の所見、その他の結果
- 利用者が平易な言葉の説明を出発点ではなく最終結論として扱ってしまう
これらのいずれも、AIヘルスアシスタントを役立たずにするものではありません――それは、判断を下すためのツールではなく、言葉を理解するためのツールにするのです。
AIドクターを安全に使う方法
正しく使えば、AIドクターは結果を受け取ることと理解することの間の隔たりを縮めます。誤って使えば、本当に必要なケアをあなたに思いとどまらせてしまうこともあります。
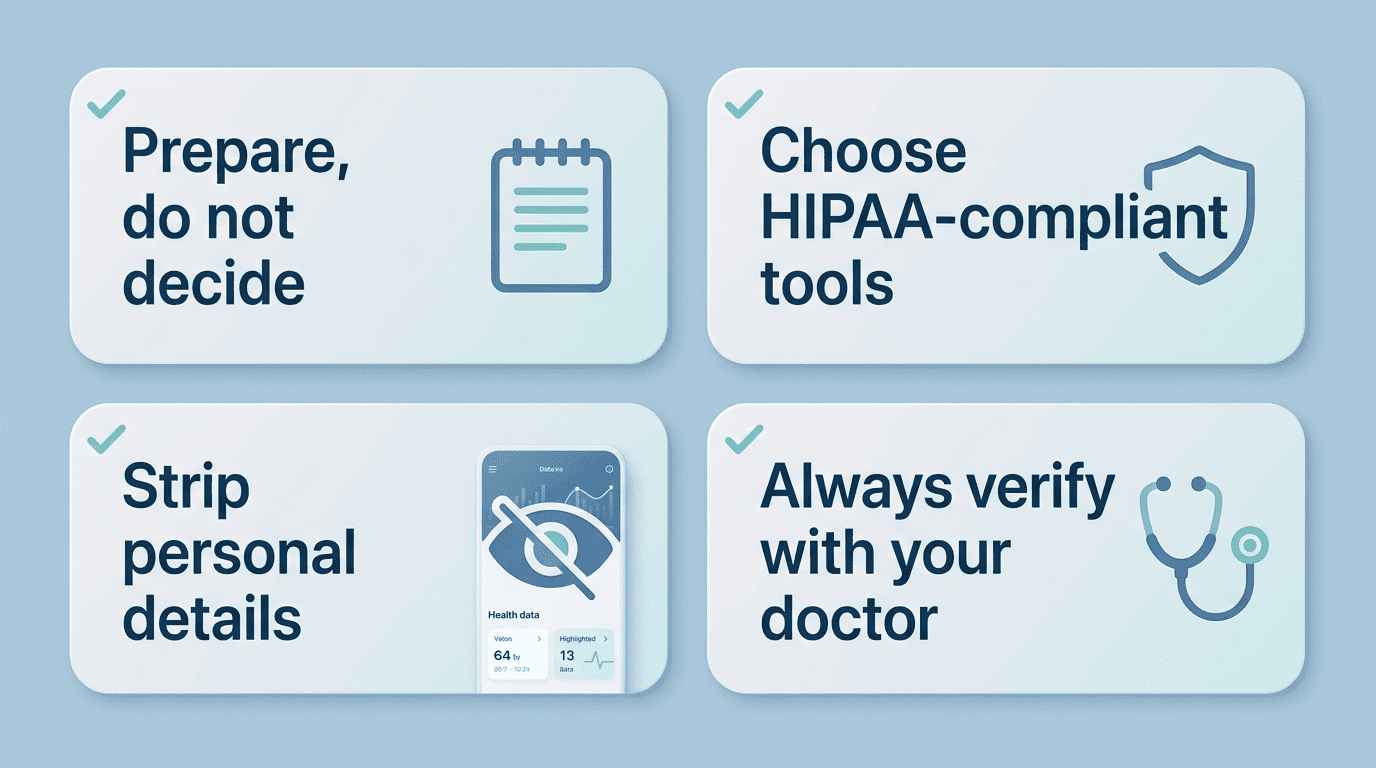
- 決めるためではなく、準備するために使う。21世紀治療法(21st Century Cures Act)の情報ブロッキング規則のもとでは、検査結果はあなたに即座に――しばしば医師がまだ見てさえいないうちに――公開されます。そのため、ある数値が異常に見えた瞬間に結論へ飛びつきたくなってしまいます。AIを使って用語を理解し、診察に向けた質問を書き留め、そのうえで結果の解釈と次に何をするかの決定は医師に委ねましょう。
- プライバシーを守る。HIPAA準拠を明記しているツールを優先し、あなたのデータを公開モデルの学習に使わないことを確認しましょう。専用の医療ツールではなく汎用チャットボットを使う場合は、個人を特定できる情報を取り除きましょう。
- あなたの行動を変えるものは何であれ、二重に確認する。今や米国の成人のおよそ3分の1が健康に関する質問に大規模言語モデルを使っており、4,000万人以上が毎日ChatGPTに健康に関する質問をしています――まさにその規模こそ、診察や服薬をやめる前に、もう一つの人間による意見が重要である理由です。
- 自信ありげな誤りに注意する。AIのハルシネーションはまさに正しい答えのように読め、何かがおかしいという組み込みの合図はありません。もし説明が医師からすでに言われたことと矛盾するなら、初期設定で新しい情報源を信じるのではなく、それを疑問として提起しましょう。
これらのルールは、AIドクターが得意なことと不得意なことの単純な切り分けに帰着します。
| 良い使い方 | 安全でない使い方 |
|---|---|
| ある用語や値が何を意味するのかを理解する | 治療を開始するか中止するかを決める |
| 診察の前に具体的な質問を準備する | AIが自信ありげだったからと医師の診察を飛ばす |
| 新しい結果について平易な言葉での第一印象を得る | 単一のAIの答えを最終的な診断として扱う |
| 早めに尋ねるべきことを見つけて印をつける | AIと矛盾するからと医師の助言を無視する |
この表こそ、安全性のモデル全体を一か所にまとめたものです。左の列はAIヘルスアシスタントがうまくこなすこと、右の列は資格を持つ医師が引き継がなければならないところです。どちらも他方の代わりにはならず、その区別について正直なツールこそ、あなた自身の結果のように個人的なものを託すに値するツールです。
Stanford Medicineのツールを支えるClaudeモデルを開発した企業であるAnthropicは、その境界線がどこにあるのかについてはっきりと述べています。同社の利用ポリシーは、医療および医療診断を、出力が使われる前に資格を持つ人間による確認を必要とする高リスクのユースケースとして挙げており、同社の広報担当者も同じ点を平易な言葉で述べています。
Claudeは臨床診断を下すために設計されたりマーケティングされたりしているわけではありません。
Anthropic広報担当者、Scientific Americanでの引用
締めくくりの安全に関する注記
AIドクターは資格を持つ医師の代わりにはならず、診断を提供するものではありません。医療上の緊急時には911に電話してください。どんな説明も、それに基づいて行動する前に必ず本物で資格を持つ医師で確認してください――AIドクターはあなたの結果の言葉を翻訳できますが、それを診断や治療計画に変えられるのは医師だけです。