ما مدى دقة الطبيب بالذكاء الاصطناعي؟ الأرقام الصادقة
الإجابة الصادقة: الطبيب بالذكاء الاصطناعي دقيق تقريبًا بقدر طبيب غير متخصص في المشكلات الشائعة، لكنه يتخلف بوضوح عن الخبير. وضعت تحليل تلوي شامل لعام 2025 في npj Digital Medicine دقة التشخيص المستقلة للذكاء الاصطناعي التوليدي عند حوالي 52%. من الأفضل التعامل مع الطبيب بالذكاء الاصطناعي عبر الإنترنت كرأي ثانٍ مطّلع، لا كحكم نهائي.
الطبيب بالذكاء الاصطناعي ليس بديلًا عن طبيب مرخّص ولا يقدّم تشخيصًا. في حالات الطوارئ الطبية اتصل بـ 911. تشرح أرقام الدقة أدناه فيما هو جيد — وأين ما زلت تحتاج إلى طبيب حقيقي بالضبط.
الإجابة المختصرة: ما مدى دقة الطبيب بالذكاء الاصطناعي فعلًا
انزع عنه التسويق وستكون الصورة بسيطة: أداة تشخيص بالذكاء الاصطناعي التوليدي، مستخدَمة بمفردها، تصل إلى الإجابة الصحيحة أكثر بقليل من نصف الوقت — وهذا الرقم الوحيد يخفي تباينًا هائلًا بحسب المهمة وجودة المدخلات ومَن تجري مقارنتها به.
رقم واحد لتثبيته: ~52%
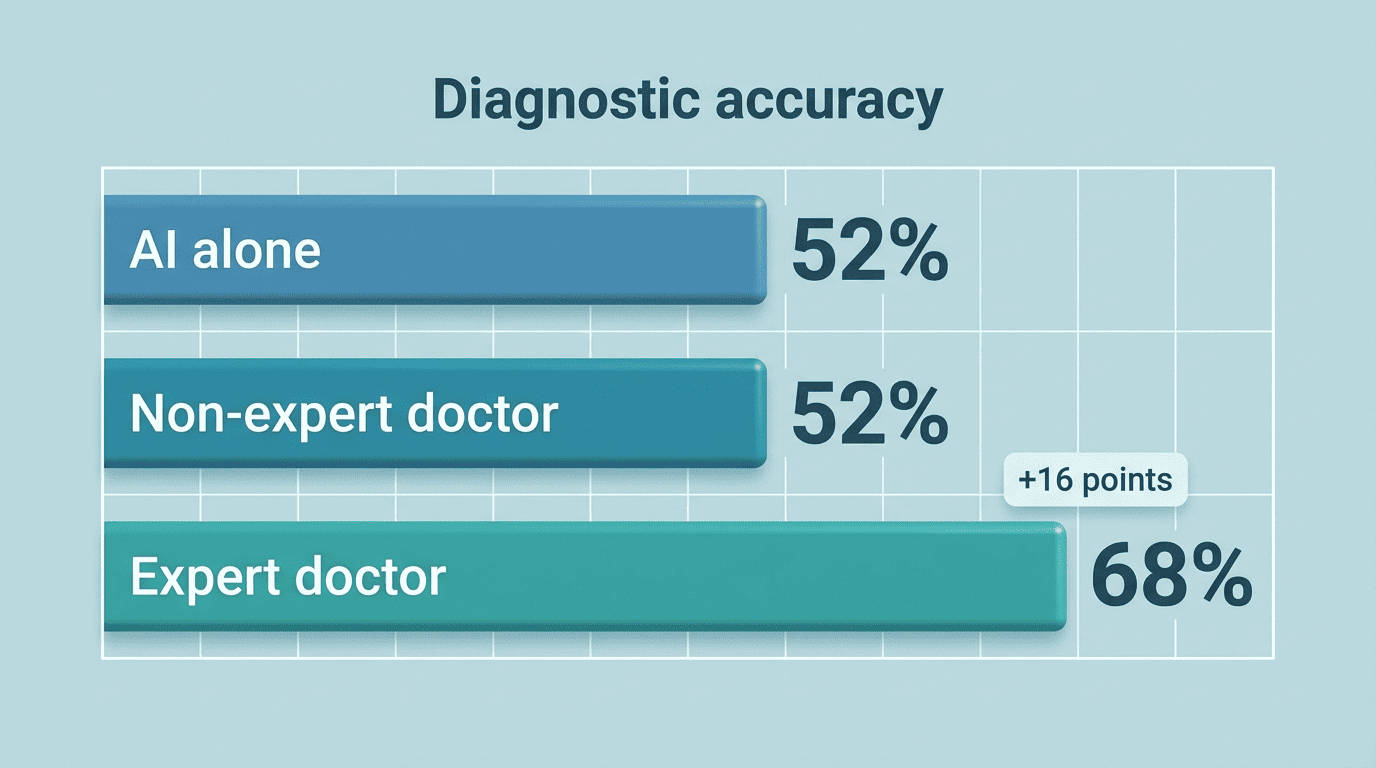
وجدت مراجعة منهجية وتحليل تلوي لعام 2025 شملت 83 دراسة، نُشرت في npj Digital Medicine، أن نماذج الذكاء الاصطناعي التوليدي تصل إلى دقة تشخيصية إجمالية قدرها 52.1% (95% CI 47.0–57.1%) عند عملها بمفردها. يبدو ذلك منخفضًا، لكنه متوسط عبر حالات سهلة وأخرى صعبة جدًا مجمّعة معًا — السياق المحيط بالرقم يهمّ أكثر من الرقم نفسه.
مقارنةً بطبيب حقيقي
وجد التحليل التلوي نفسه عدم وجود فرق ذي دلالة إحصائية بين الذكاء الاصطناعي والأطباء إجمالًا (p=0.10)، ولا فرق ذي دلالة مقابل الأطباء غير الخبراء أو الأطباء المقيمين (p=0.93). لكن الذكاء الاصطناعي كان أسوأ بشكل ملحوظ من الأطباء الخبراء — بحوالي 15.8 نقطة مئوية (p=0.007). بعبارة واضحة: مدقّق الأعراض بالذكاء الاصطناعي مماثل لطبيب عام حديث التخرّج، ومتخلّف بوضوح عن أخصائي يمتلك سنوات من التعرّف على الأنماط — ووضع الطبيب بالذكاء الاصطناعي مقابل طبيب حقيقي جنبًا إلى جنب يُظهر اتساع تلك الفجوة كلما صعبت الحالة.
لماذا يقفز رقم الدقة بهذا القدر
سيلاحظ أي شخص يقارن العناوين أرقامًا شديدة الاختلاف — 97% في دراسة و40% في أخرى. يعود هذا التباين في الغالب إلى حفنة من المتغيرات التي نادرًا ما تُذكر في العنوان نفسه:
- كيف جُمعت المدخلات — رسم بياني سريري منظّم مقابل كلمات المريض نفسه
- هل تعني «الصحيحة» الإجابة الأولى الوحيدة أم أي إجابة ضمن أفضل 3-5 اقتراحات
- مدى شيوع أو ندرة الحالة الكامنة
- أي نموذج وإصدار جرى اختباره، ومتى
- هل قاست الدراسة التشخيص أم الفرز أم كليهما
مدخلات رديئة، مخرجات رديئة: جودة المدخلات هي كل شيء
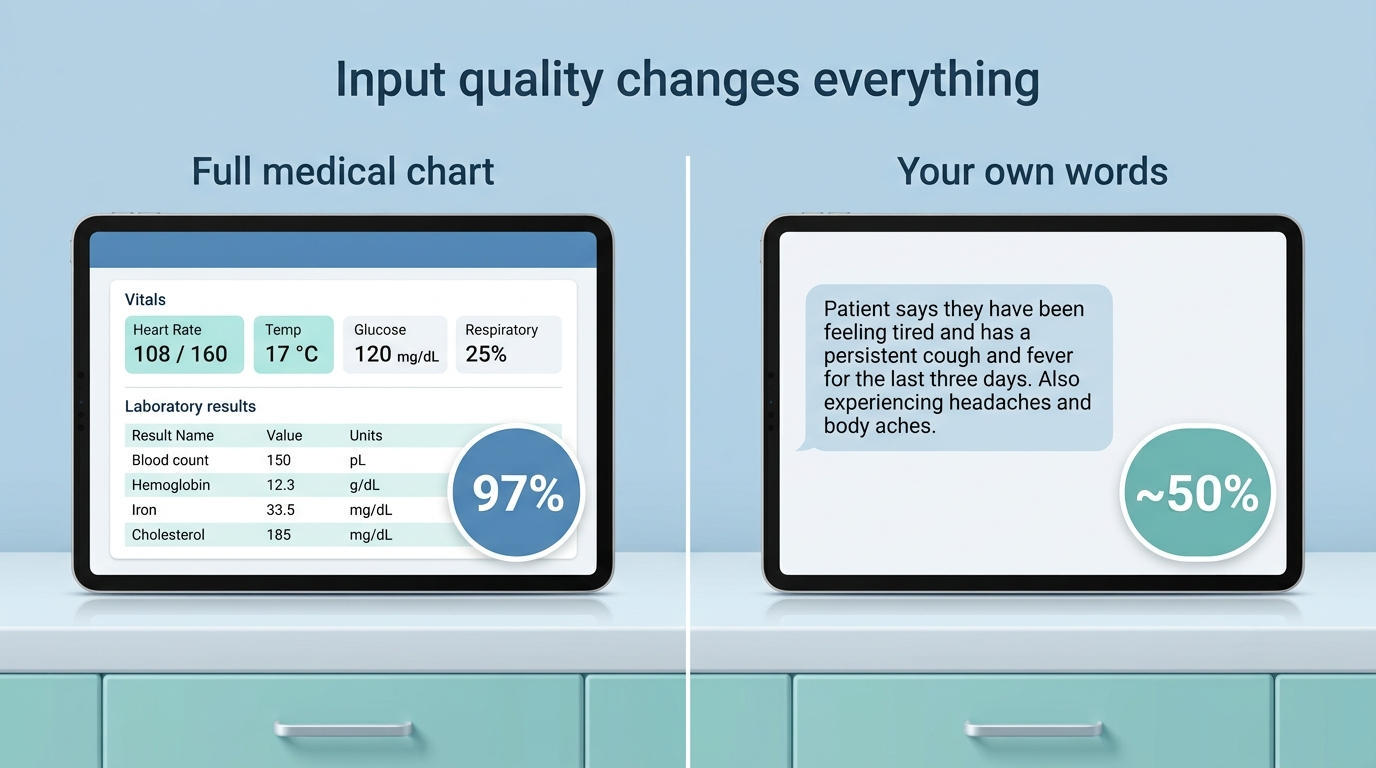
في دراسة JMIR شملت 100 مريض في قسم الطوارئ، وصل ChatGPT العامل على GPT-4 إلى 97% من التشخيصات الصحيحة أو الصحيحة جزئيًا — لكن فقط لأنه غُذّي بالرسم البياني نفسه الذي أعدّه الأطباء واستخدموه، مكتملًا بالعلامات الحيوية والتحاليل والملاحظات السريرية. وعند إعطائه أعراض المريض الخام المُبلَّغ عنها ذاتيًا فقط، تنخفض دقة النوع نفسه من النموذج إلى حوالي 50% لمطابقة ضمن أفضل 3. أداة التشخيص بالذكاء الاصطناعي جيدة فقط بقدر ما تخبرها به، وفهم كيف يعمل الطبيب بالذكاء الاصطناعي في الخفاء يفسّر لماذا يمكن للنموذج نفسه أن يتأرجح بهذا القدر بناءً على جودة المدخلات وحدها.
أفضل 1 مقابل أفضل 3: أي رقم يقتبسونه؟
عادةً ما يعني ادّعاء «دقة 70-80%» أن الإجابة الصحيحة تظهر في مكان ما ضمن أفضل ثلاثة اقتراحات لأداة الفرز بالذكاء الاصطناعي، لا أنها سمّت الحالة الصحيحة أولًا. اطلب من النظام نفسه إجابة واحدة وقد تنخفض الدقة إلى 34-40%. عندما ترى ادّعاء دقة لأي مساعد صحي بالذكاء الاصطناعي، تحقّق هل هو top-1 أم top-3 — فهما وعدان مختلفان جدًا، ويميل الموردون إلى تقديم الأكثر تملّقًا منهما.
| القياس | الدقة النموذجية | ما يعنيه |
|---|---|---|
| Top-1 (أفضل إجابة واحدة) | 34-40% | التشخيص الصحيح مذكور أولًا، دون بدائل مقدَّمة |
| Top-3 (الإجابة الصحيحة ضمن قائمة مختصرة) | 70-80% | الحالة الصحيحة تظهر بين 3 اقتراحات |
| مدخلات مُعدّة من طبيب (رسم كامل) | حتى 97% | مُغذّى بالبيانات المنظّمة نفسها التي يستخدمها الطبيب |
| تقرير ذاتي من المريض فقط | ~50% (top-3) | مُغذّى بأوصاف أعراض خام وغير منظّمة |
أين يكون الطبيب بالذكاء الاصطناعي دقيقًا — وأين يفشل
الدقة التشخيصية ليست مهارة واحدة؛ إنها عدة مهارات، والطبيب بالذكاء الاصطناعي أفضل بكثير في بعضها منه في غيرها. معرفة أيّها أيّ يغيّر كيف ينبغي أن تستخدم الأداة فعلًا.
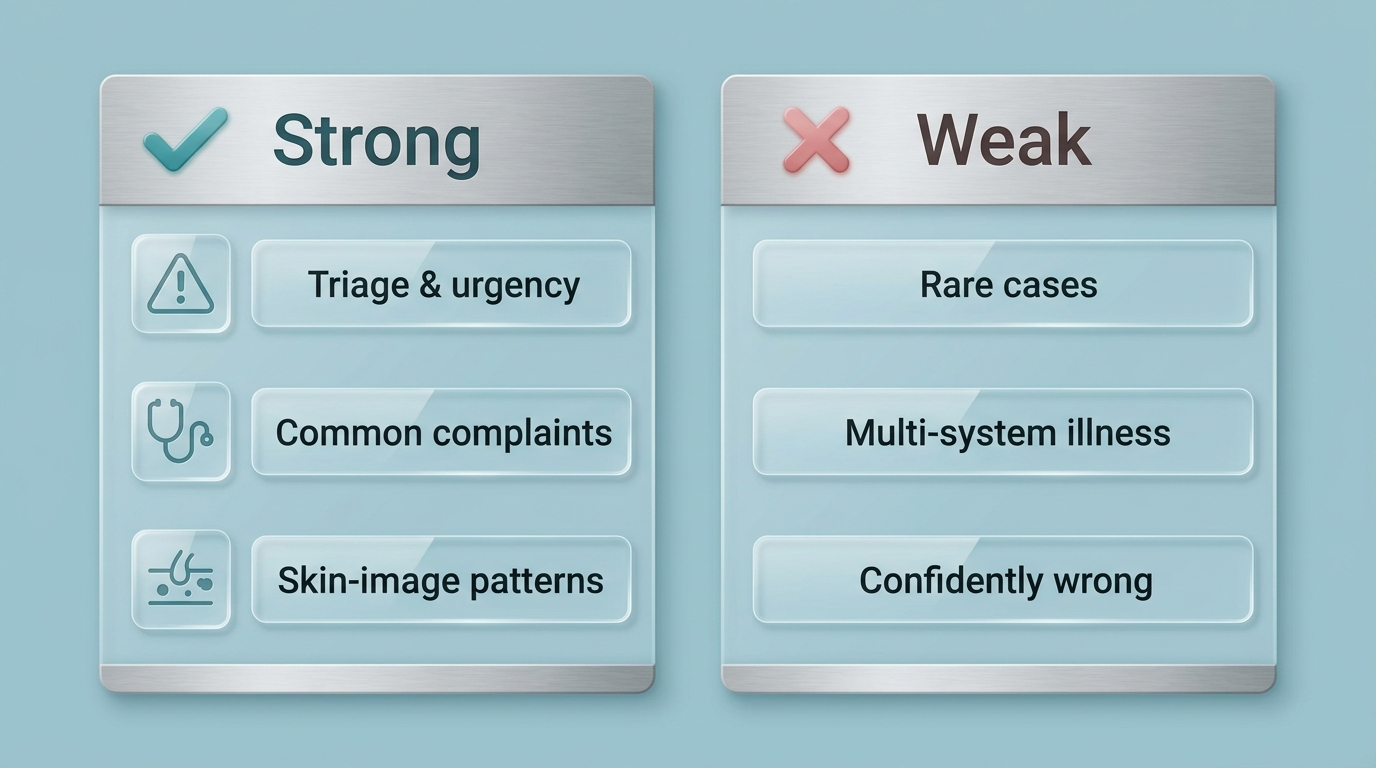
قوي في الفرز. يكون الطبيب بالذكاء الاصطناعي أكثر موثوقية عندما يكون السؤال «ما مدى إلحاح هذا»، لا «ما هذا بالضبط». فرز عرَض ما إلى طارئ أو عاجل أو روتيني مهمة أضيق وأوضح تعريفًا من الوصول إلى تشخيص نهائي، وتميل النماذج إلى أدائها باتساق أكبر.
قوي في الشكاوى الشائعة الموثّقة جيدًا. المشكلات المباشرة المتكررة الرؤية — من النوع الذي يمتلك بيانات تدريب وفيرة وأنماط أعراض واضحة — تلعب لصالح نقاط قوة أداة التشخيص بالذكاء الاصطناعي التوليدي.
قوي في التخصصات الضيقة المكثّفة بالصور. في مهام التعرّف على الأنماط مثل الأمراض الجلدية، وجد تحليل مجمّع لدراسات استباقية لاكتشاف الميلانوما أن الذكاء الاصطناعي وحده يصل إلى حوالي 80.9% حساسية و75.6% نوعية — مماثلًا لأطباء الجلد بلا مساعدة — ويرتفع إلى حوالي 91.9% حساسية و83.7% نوعية عندما يساعد الذكاء الاصطناعي طبيب الجلد بدلًا من أن يحلّ محلّه. مشكلات الأنماط البصرية المحدّدة جيدًا قريبة من ميدان الأداة الأصلي.
ضعيف في الحالات المعقّدة أو النادرة أو متعددة الأجهزة. تنخفض الدقة بحدّة عندما تتداخل الأعراض عبر أجهزة الجسم أو تشير إلى حالة غير شائعة — وهو بالضبط حيث يهمّ حكم الطبيب الخبير أكثر ما يكون.
ضعيف بطريقة يسهل تفويتها: الخطأ الواثق. يمكن للطبيب بالذكاء الاصطناعي أن يذكر تشخيصًا خاطئًا بلغة طليقة ومطمئنة، دون أي تحفّظ مرئي يشير إلى الشك. النتيجة التي تبدو معقولة ليست كالنتيجة الصحيحة، وهذا بالضبط لماذا لا تزال المراجعة البشرية مهمة.
هل يمكنك الوثوق بالدراسات؟ اقرأ التفاصيل الدقيقة
حتى الأرقام المشجّعة أعلاه تأتي مع محاذير تستحق المعرفة قبل أن تزنها.
في التحليل التلوي المكوّن من 83 دراسة، صُنّفت 63 من 83 دراسة — 76% — على أنها ذات خطر تحيّز مرتفع، وأشار المؤلفون إلى تحيّز نشر ذي دلالة إحصائية (p=0.045)، ما يعني أن النتائج المتملّقة على الأرجح ممثَّلة بشكل مفرط في الأدبيات المنشورة. جاءت نتيجة قسم الطوارئ الجاذبة للعناوين البالغة 97% من دراسة واحدة شملت 100 مريض فقط، دون حساب مسبق لحجم العينة يؤكد ثبات النتيجة على نطاق أوسع.
| القيد | ما تُظهره البيانات | لماذا يهمّ |
|---|---|---|
| خطر التحيّز | 63 من 83 دراسة (76%) مصنّفة خطرًا مرتفعًا | كثير من النتائج قد تكون أفضل مما ينتجه الاستخدام الواقعي |
| تحيّز النشر | ذو دلالة إحصائية (p=0.045) | الدراسات ذات النتائج المخيّبة أقل احتمالًا للنشر |
| عينات صغيرة | دراسة الطوارئ مبنية على 100 مريض | لا حجم عينة مخطط مسبقًا لتأكيد تعميم رقم 97% |
| مدخلات مُعدّة مقابل خام | 97% (رسم مُعدّ) مقابل ~50% (تقرير ذاتي) | دقة النموذج نفسه تتأرجح بنحو 47 نقطة تبعًا لجودة المدخلات |
تظهر بضع فجوات متكررة عبر هذه المجموعة من الأبحاث:
- معظم الدراسات تختبر الذكاء الاصطناعي مقابل مقاطع نصية، لا محادثات واقعية فوضوية
- قليل من التجارب تقيس ما يحدث بعد إجابة خاطئة من الذكاء الاصطناعي، أي الضرر اللاحق
- أحجام العينات غالبًا صغيرة جدًا بحيث لا تدعم الثقة التي يوحي بها الرقم في العنوان
- التكرار المستقل خارج فريق البحث الأصلي لا يزال نادرًا
كان مؤلفو ذلك التحليل التلوي صريحين بشأن ما تعنيه أرقامهم:
نماذج الذكاء الاصطناعي التوليدي ليست بعد بدائل موثوقة عن الأطباء الخبراء، لكنها قد تكون معينات قيّمة في السيناريوهات غير التخصصية وأدوات تعليمية للمتدربين الطبيين. تحليل تلوي في npj Digital Medicine، 2025
تعامل مع أرقام الدقة في العناوين على أنها سقوف متفائلة، لا ضمانات. الرقم المأخوذ من دراسة صغيرة عالية خطر التحيّز ليس كالرقم الذي سيصمد لأعراضك المحدّدة.
كيف تستخدم الطبيب بالذكاء الاصطناعي بأمان بالنظر إلى دقته
بالنظر إلى الأرقام أعلاه، الخطوة الذكية هي مطابقة الأداة مع ما هي جيدة فيه فعلًا بدلًا من ما تبدو قادرة عليه.
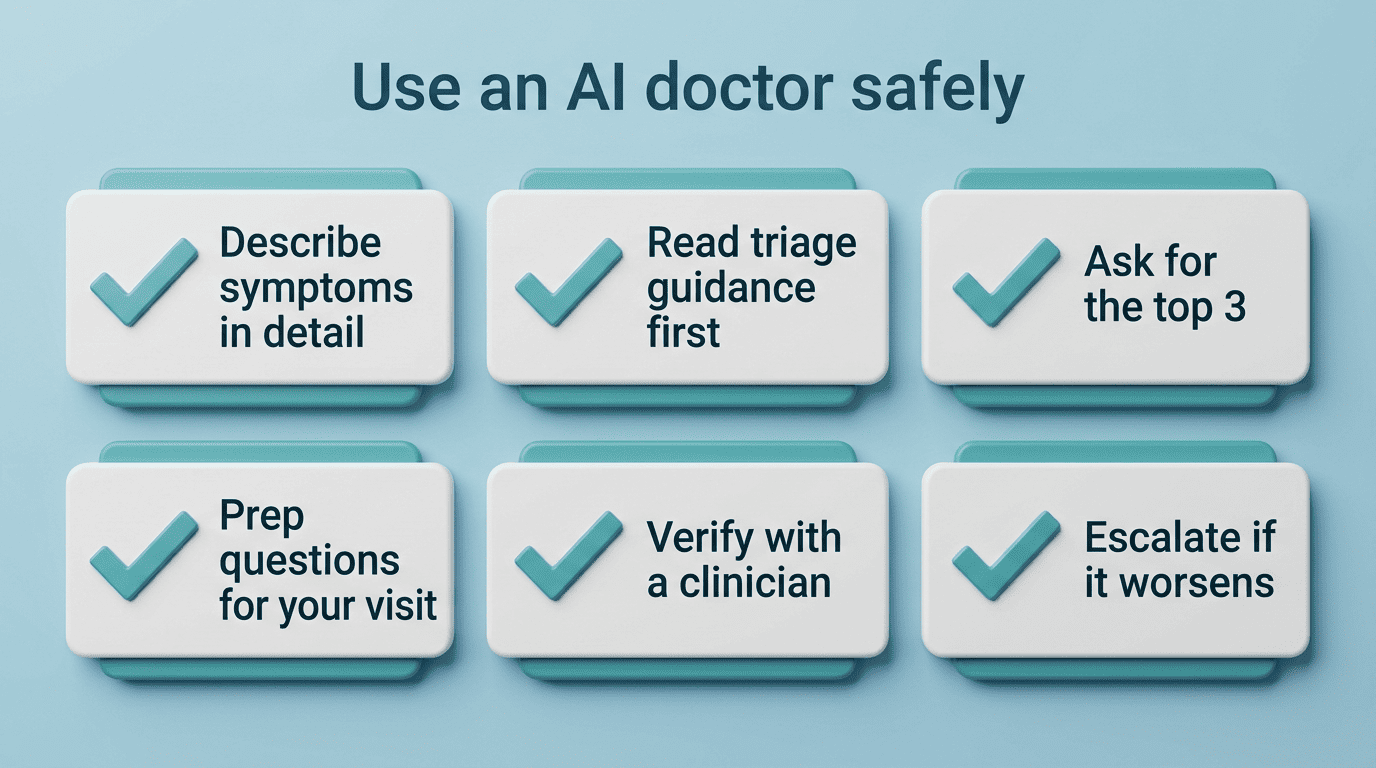
- صِف الأعراض بالتفصيل، لا بالاختصار. تعتمد الدقة بشدة على جودة المدخلات، لذا أدرج المدة والشدّة وأي تغيّرات بمرور الوقت.
- اقرأ إرشادات الفرز أولًا. تقييم الإلحاح هو حيث يؤدي مدقّق الأعراض بالذكاء الاصطناعي بأعلى موثوقية — انتبه إذا صنّف شيئًا على أنه عاجل.
- اطلب أفضل 3، لا أفضل 1 فقط. قائمة مختصرة من الاحتمالات أكثر صدقًا من إجابة واحدة تبدو واثقة.
- استخدمه للتحضير لأسئلة موعد حقيقي. تحويل القلق الغامض إلى قائمة محدّدة من الأسئلة هو أحد أكثر استخدامات الأداة موثوقية.
- تحقّق من أي شيء مهمّ مع طبيب مرخّص، خصوصًا للأعراض الجديدة أو الخطيرة أو المستمرة.
- صعّد فورًا إذا ساءت الأعراض — لا تنتظر أن يلحق الذكاء الاصطناعي بالركب.
- لا تعامل أبدًا إجابة واحدة من الذكاء الاصطناعي على أنها نهائية. راجعها مقابل شعورك الفعلي ومقابل نصيحة المختصين.
تميل أداة التشخيص بالذكاء الاصطناعي إلى أن تكون الأكثر فائدة لمجموعة محدّدة من المهام والأقل فائدة لغيرها. قبل الاعتماد على واحدة، يساعد أن تعرف على أي جانب من هذا الخط يقع وضعك:
- فهم المصطلحات الطبية غير المألوفة من نتيجة تحليل أو خطاب إحالة
- تقدير مدى إلحاح عرَض جديد قد يكون
- إعداد قائمة واضحة من الأسئلة قبل زيارة الطبيب
- الحصول على تثقيف صحي عام حول حالة تعاني منها بالفعل
- الاختيار بين زيارة في نفس اليوم أو موعد مجدول أو مراقبة يقظة
الإجماع الخاضع لمراجعة الأقران صريح: الذكاء الاصطناعي التوليدي معين قيّم في السيناريوهات غير التخصصية، لا بديل موثوق عن طبيب خبير. تتبّع إدارة الغذاء والدواء الأمريكية الأجهزة الطبية المُمكّنة بالذكاء الاصطناعي المصرّح بتسويقها بالضبط لأن مخرجات الذكاء الاصطناعي غير المتحقَّق منها تحمل خطرًا سريريًا حقيقيًا — تذكير بأن المنظّمين، لا الباحثين فحسب، يتعاملون مع فجوة الدقة هذه على أنها جوهرية.
متى تتجاوز الذكاء الاصطناعي وترى طبيبًا حقيقيًا
الطبيب بالذكاء الاصطناعي ليس بديلًا عن طبيب مرخّص ولا يقدّم تشخيصًا. في حالات الطوارئ الطبية اتصل بـ 911.
لا نسبة دقة — لا 52%، ولا 97% في ظروف مثالية — تجعل أداة التشخيص بالذكاء الاصطناعي آمنة للاعتماد عليها في عرَض خطير أو مفاجئ أو متفاقم. تجاوز الذكاء الاصطناعي واذهب مباشرة إلى طبيب حقيقي أو رعاية طارئة لأعراض مثل:
- ألم أو ضغط في الصدر، أو صعوبة في التنفّس
- صداع مفاجئ شديد لا يشبه أي صداع سابق
- نزيف لا يمكن السيطرة عليه أو إصابة تتفاقم بسرعة
- علامات السكتة الدماغية — تدلّي الوجه، ضعف الذراع، تلعثم الكلام
- أي عرَض يبدو ببساطة كحالة طارئة
استخدم مساعدًا صحيًا بالذكاء الاصطناعي لتثقيف نفسك وتنظيم تفكيرك، ثم دع طبيبًا مرخّصًا يتخذ القرار الفعلي.