
Wie genau ist ein KI-Arzt? Die ehrlichen Zahlen
Die ehrliche Antwort: Ein KI-Arzt ist bei häufigen Beschwerden ungefähr so genau wie ein nicht spezialisierter Arzt, bleibt aber deutlich hinter einem Experten zurück. Eine große Metaanalyse von 2025 in npj Digital Medicine bezifferte die eigenständige diagnostische Genauigkeit von generativer KI auf etwa 52 %. Ein KI-Arzt online sollte am besten als gut belesene Zweitmeinung verstanden werden, nicht als Urteil.
Ein KI-Arzt ist bei häufigen Problemen ungefähr so genau wie ein Nichtspezialist – eine gut belesene Zweitmeinung, kein Urteil.
Ein KI-Arzt ist kein Ersatz für einen approbierten Arzt und stellt keine Diagnose. Bei medizinischen Notfällen wählen Sie 911. Die folgenden Genauigkeitszahlen erklären, wofür er gut ist – und wo genau Sie weiterhin einen echten Arzt brauchen.
Die kurze Antwort: Wie genau ein KI-Arzt wirklich ist
Wenn man das Marketing beiseitelässt, ist das Bild einfach: Ein generatives KI-Diagnosetool liefert für sich allein etwas mehr als die Hälfte der Fälle die richtige Antwort – und diese eine Zahl verbirgt enorme Schwankungen je nach Aufgabe, Qualität der Eingabe und der Vergleichsgruppe.
Eine Zahl als Orientierungspunkt: ~52 %
Eine systematische Übersichtsarbeit und Metaanalyse von 2025, die 83 Studien umfasst und in npj Digital Medicine veröffentlicht wurde, ergab, dass generative KI-Modelle eine diagnostische Gesamtgenauigkeit von 52,1 % (95 %-KI 47,0–57,1 %) erreichen, wenn sie eigenständig arbeiten. Das klingt niedrig, ist aber ein Durchschnitt über leichte und sehr schwere Fälle zusammengefasst – der Kontext um die Zahl herum ist wichtiger als die Zahl selbst.
Im Vergleich mit einem echten Arzt
Dieselbe Metaanalyse fand insgesamt keinen statistisch signifikanten Unterschied zwischen KI und Ärzten (p=0,10) und keinen signifikanten Unterschied gegenüber nicht spezialisierten Ärzten oder Assistenzärzten (p=0,93). Doch die KI schnitt signifikant schlechter ab als Fachärzte – um etwa 15,8 Prozentpunkte (p=0,007). Im Klartext: Ein KI-Symptomchecker ist mit einem Allgemeinmediziner frisch nach der Ausbildung vergleichbar und liegt klar hinter einem Spezialisten mit jahrelanger Mustererkennung – und stellt man einen KI-Arzt einem echten Arzt gegenüber, sieht man, wie sich diese Lücke vergrößert, je schwieriger der Fall wird.
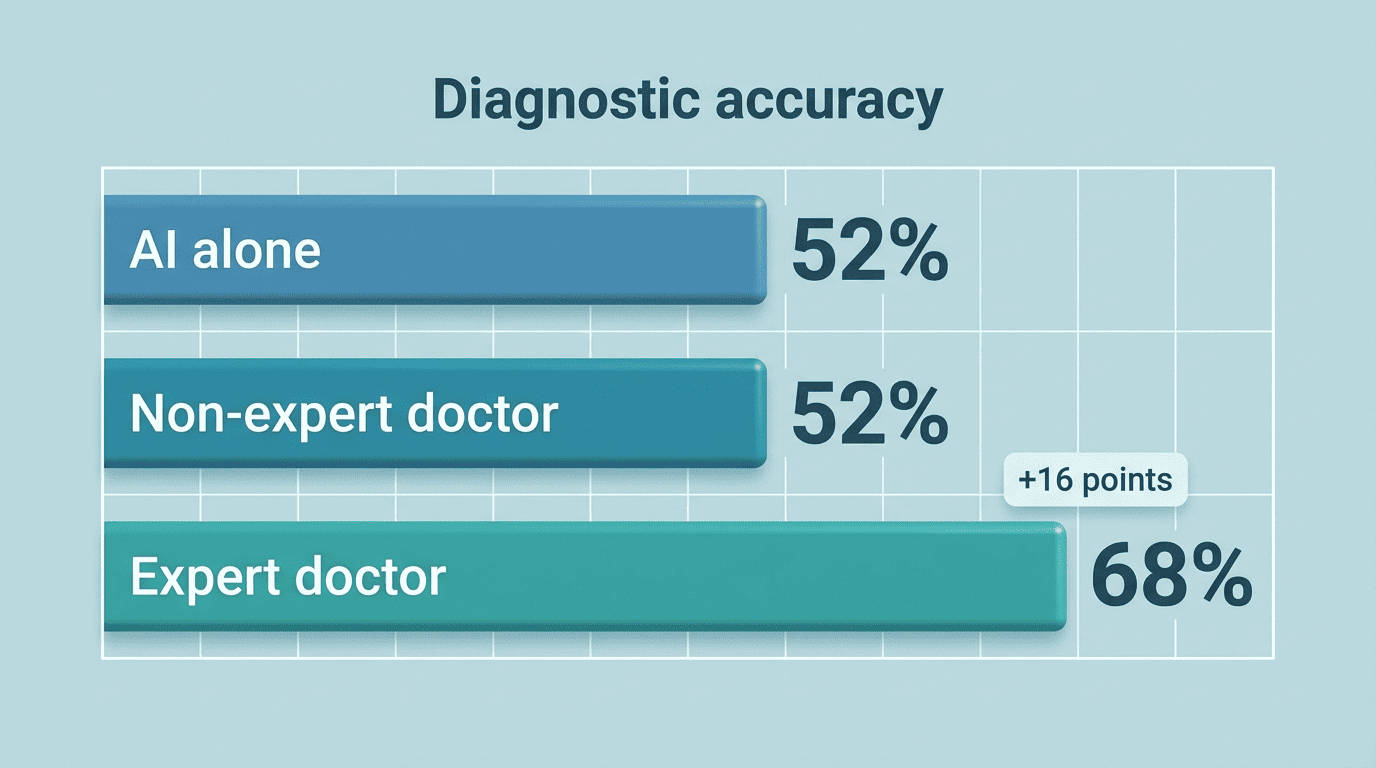
Eigenständige KI erreicht etwa 52 % – gleichauf mit einem nicht spezialisierten Arzt, aber rund 16 Punkte hinter einem Spezialisten.
Warum die Genauigkeitszahl so stark schwankt
Wer Schlagzeilen vergleicht, bemerkt völlig unterschiedliche Werte – 97 % in einer Studie, 40 % in einer anderen. Diese Spannbreite lässt sich meist auf eine Handvoll Variablen zurückführen, die in der Schlagzeile selbst kaum erwähnt werden:
- Wie die Eingabe erfasst wurde – eine strukturierte klinische Akte gegenüber den eigenen Worten eines Patienten
- Ob „korrekt“ die einzige beste Antwort meint oder eine der 3–5 besten Vorschläge
- Wie häufig oder selten die zugrunde liegende Erkrankung ist
- Welches Modell und welche Version getestet wurde, und wann
- Ob die Studie Diagnose, Triage oder beides gemessen hat
Garbage in, garbage out: Die Qualität der Eingabe ist alles
In einer JMIR-Studie mit 100 Patienten der Notaufnahme erreichte ChatGPT auf Basis von GPT-4 in 97 % der Fälle korrekte oder teilweise korrekte Diagnosen – aber nur, weil es mit derselben von Ärzten kuratierten Akte gefüttert wurde, die auch die behandelnden Ärzte nutzten, samt Vitalwerten, Laborwerten und klinischen Notizen. Bekommt dasselbe Modell nur die rohen, selbst berichteten Symptome eines Patienten, fällt seine Genauigkeit auf rund 50 % für einen Top-3-Treffer. Das KI-Diagnosetool ist nur so gut wie das, was Sie ihm mitteilen, und wer versteht, wie ein KI-Arzt funktioniert, begreift auch, warum genau dasselbe Modell allein aufgrund der Eingabequalität so stark schwanken kann.
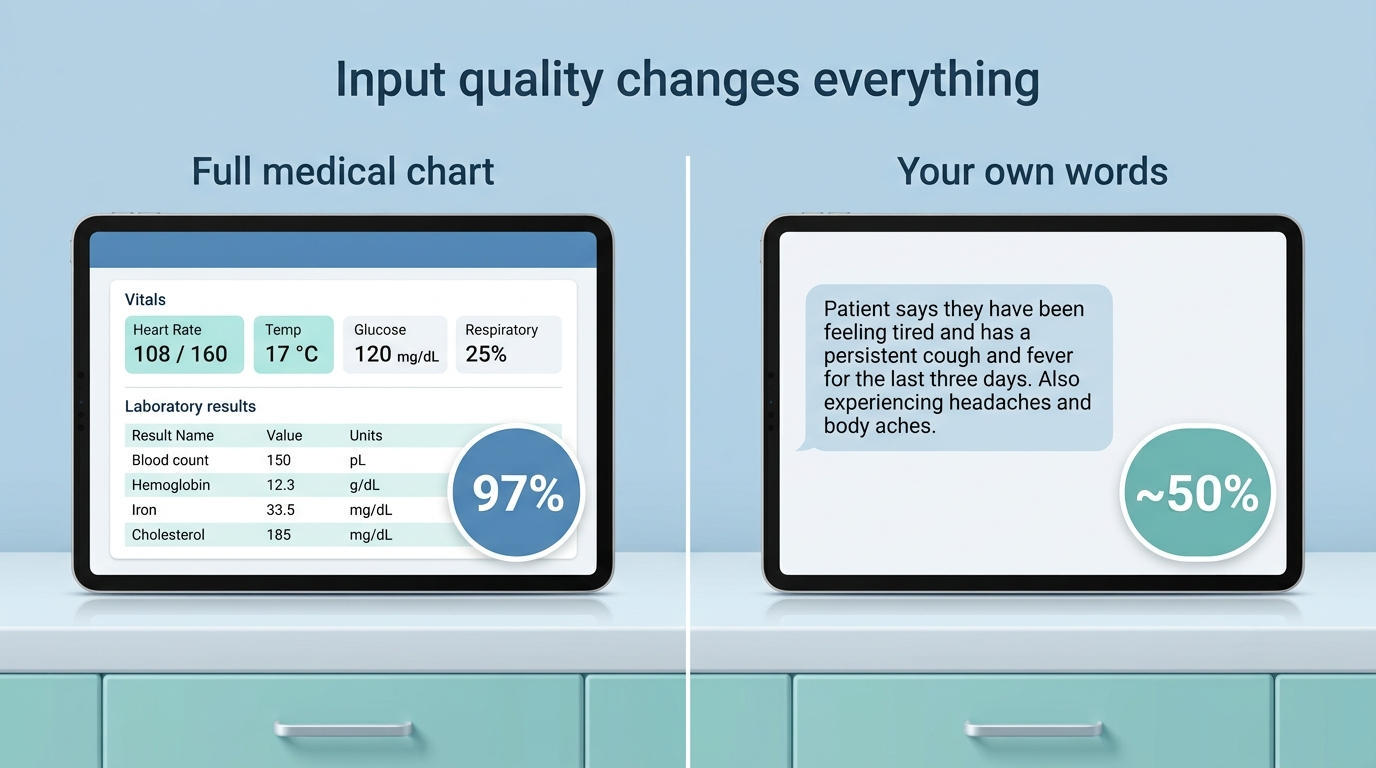
Die Genauigkeit schwankt mit der Eingabequalität: Eine vollständige klinische Akte kann 97 % erreichen, Ihre eigenen Worte etwa 50 %.
Top-1 vs. Top-3: Welche Zahl wird zitiert?
Eine Behauptung von „70–80 % genau“ bedeutet in der Regel, dass die richtige Antwort irgendwo unter den drei besten Vorschlägen des KI-Triage-Tools auftaucht, nicht dass es die richtige Erkrankung an erster Stelle genannt hat. Fragt man dasselbe System nach einer einzigen Antwort, kann die Genauigkeit auf 34–40 % sinken. Wenn Sie eine Genauigkeitsangabe für einen KI-Gesundheitsassistenten sehen, prüfen Sie, ob es sich um Top-1 oder Top-3 handelt – das sind sehr unterschiedliche Versprechen, und Anbieter führen gern das schmeichelhaftere an.
| Messung | Typische Genauigkeit | Was es bedeutet |
|---|---|---|
| Top-1 (einzige beste Antwort) | 34–40 % | Richtige Diagnose zuerst genannt, keine Alternativen angeboten |
| Top-3 (richtige Antwort in der engeren Auswahl) | 70–80 % | Richtige Erkrankung erscheint unter 3 Vorschlägen |
| Von Ärzten kuratierte Eingabe (vollständige Akte) | Bis zu 97 % | Gefüttert mit denselben strukturierten Daten, die ein Arzt nutzt |
| Nur Selbstauskunft des Patienten | ~50 % (Top-3) | Gefüttert mit rohen, unstrukturierten Symptombeschreibungen |
Wo ein KI-Arzt genau ist – und wo er versagt
Diagnostische Genauigkeit ist keine einzelne Fähigkeit; sie umfasst mehrere, und ein KI-Arzt ist in einigen deutlich besser als in anderen. Zu wissen, was was ist, verändert, wie Sie das Tool tatsächlich einsetzen sollten.
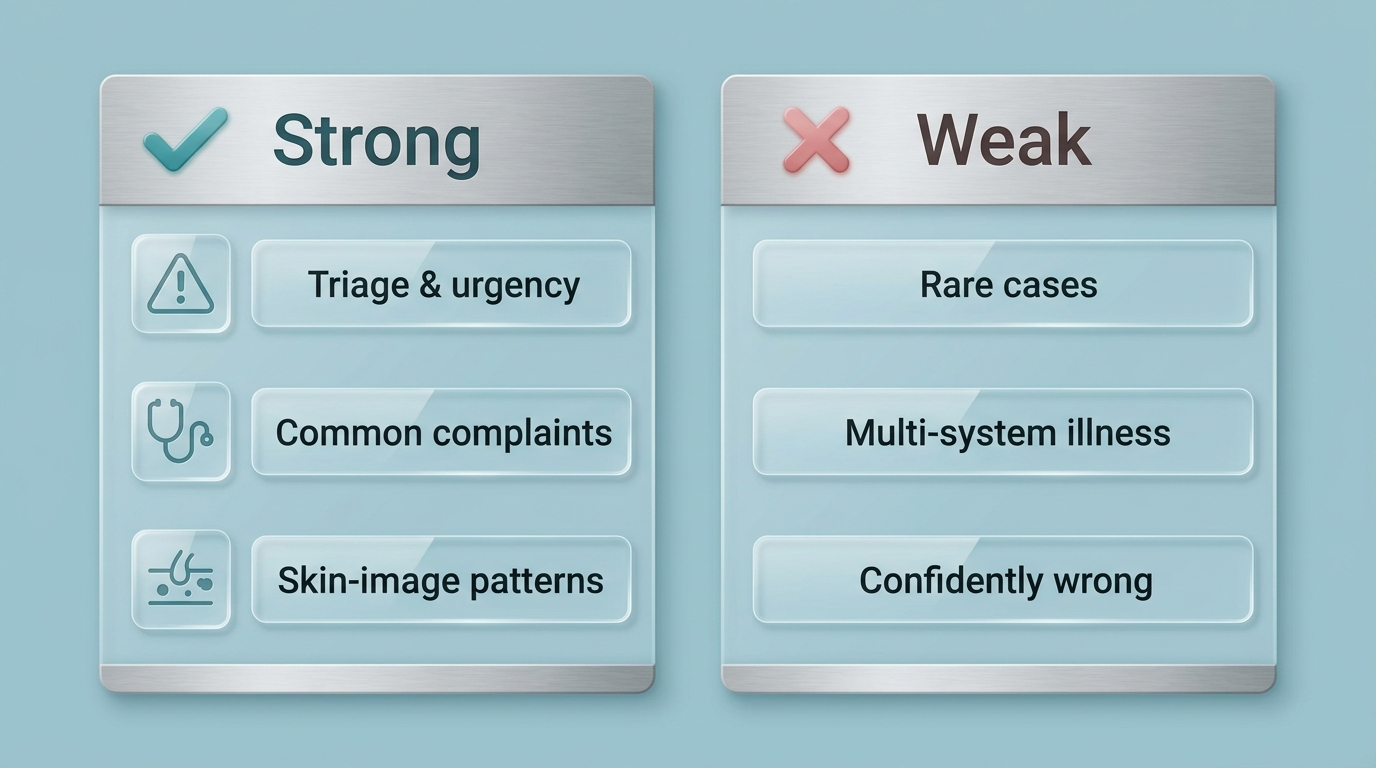
Ein KI-Arzt ist stark bei Triage, häufigen Beschwerden und Bildmustern – schwach bei seltenen, mehrere Organsysteme betreffenden Fällen und bei selbstsicherer Fehleinschätzung.
Stark bei der Triage. Ein KI-Arzt ist am zuverlässigsten, wenn die Frage lautet „Wie dringend ist das?“ und nicht „Was genau ist das?“. Ein Symptom in Notfall, dringend oder routinemäßig einzuordnen, ist eine engere, besser definierte Aufgabe als das Stellen einer endgültigen Diagnose, und Modelle erledigen sie tendenziell konsistenter.
Stark bei häufigen, gut dokumentierten Beschwerden. Unkomplizierte, häufig gesehene Probleme – solche mit reichlich Trainingsdaten und klaren Symptommustern – spielen die Stärken eines generativen KI-Diagnosetools aus.
Stark in engen, bildlastigen Fachgebieten. Bei Mustererkennungsaufgaben wie in der Dermatologie ergab eine gepoolte Analyse prospektiver Studien zur Melanomerkennung, dass KI allein eine Sensitivität von etwa 80,9 % und eine Spezifität von 75,6 % erreicht – vergleichbar mit Dermatologen ohne Unterstützung – und auf rund 91,9 % Sensitivität und 83,7 % Spezifität steigt, wenn die KI einen Dermatologen unterstützt, statt ihn zu ersetzen. Klar definierte visuelle Musterprobleme liegen nahe am Heimspiel des Tools.
Schwach bei komplexen, seltenen oder mehrere Organsysteme betreffenden Fällen. Die Genauigkeit sinkt stark, wenn sich Symptome über mehrere Körpersysteme überlagern oder auf eine ungewöhnliche Erkrankung hinweisen – genau dort, wo das Urteil eines Facharztes am meisten zählt.
Schwach auf eine Weise, die leicht zu übersehen ist: selbstsichere Fehleinschätzung. Ein KI-Arzt kann eine falsche Diagnose in flüssiger, beruhigender Sprache formulieren, ohne sichtbaren Vorbehalt, der Zweifel signalisiert. Ein plausibel klingendes Ergebnis ist nicht dasselbe wie ein korrektes – genau deshalb bleibt eine menschliche Kontrolle wichtig.
Kann man den Studien trauen? Lesen Sie das Kleingedruckte
Selbst die ermutigenden Zahlen oben haben Einschränkungen, die man kennen sollte, bevor man sie gewichtet.
In der Metaanalyse mit 83 Studien wurden 63 von 83 Studien – 76 % – mit einem hohen Verzerrungsrisiko bewertet, und die Autoren wiesen auf eine statistisch signifikante Publikationsverzerrung hin (p=0,045), was bedeutet, dass schmeichelhafte Ergebnisse in der veröffentlichten Literatur wahrscheinlich überrepräsentiert sind. Das schlagzeilenträchtige 97 %-Ergebnis aus der Notaufnahme stammte aus einer einzigen Studie mit gerade einmal 100 Patienten, ohne vorab geplante Fallzahlberechnung, die bestätigt hätte, dass der Befund auch im großen Maßstab standhält.
| Einschränkung | Was die Daten zeigen | Warum es wichtig ist |
|---|---|---|
| Verzerrungsrisiko | 63 von 83 Studien (76 %) als hohes Risiko bewertet | Viele Ergebnisse könnten günstiger ausfallen, als der Einsatz in der Praxis ergäbe |
| Publikationsverzerrung | Statistisch signifikant (p=0,045) | Studien mit enttäuschenden Ergebnissen werden seltener veröffentlicht |
| Kleine Stichproben | Notaufnahme-Studie basiert auf 100 Patienten | Keine vorab geplante Fallzahl, um zu bestätigen, dass sich die 97 % verallgemeinern lassen |
| Kuratierte vs. rohe Eingabe | 97 % (kuratierte Akte) vs. ~50 % (Selbstauskunft) | Die Genauigkeit desselben Modells schwankt je nach Eingabequalität um rund 47 Punkte |
Ein paar wiederkehrende Lücken tauchen in dieser Forschung immer wieder auf:
- Die meisten Studien testen KI anhand textbasierter Fallvignetten, nicht anhand chaotischer Gespräche aus der realen Welt
- Nur wenige Studien messen, was nach einer falschen KI-Antwort passiert, also den Folgeschaden
- Die Stichprobengrößen sind oft zu klein, um die von der Schlagzeilenzahl suggerierte Sicherheit zu stützen
- Eine unabhängige Replikation außerhalb des ursprünglichen Forschungsteams ist noch immer selten
Die Autoren dieser Metaanalyse äußerten sich unverblümt darüber, was ihre eigenen Zahlen bedeuten:
Generative KI-Modelle sind noch kein zuverlässiger Ersatz für Fachärzte, können aber als wertvolle Hilfsmittel in Szenarien ohne Fachexpertise und als Lernwerkzeuge für angehende Ärzte dienen. — Metaanalyse in npj Digital Medicine, 2025
Betrachten Sie Genauigkeitswerte aus Schlagzeilen als optimistische Obergrenzen, nicht als Garantien. Eine Zahl aus einer kleinen Studie mit hohem Verzerrungsrisiko ist nicht dasselbe wie eine Zahl, die für Ihre konkreten Symptome Bestand hat.
Wie Sie einen KI-Arzt angesichts seiner Genauigkeit sicher nutzen
Angesichts der obigen Zahlen ist der kluge Weg, das Tool auf das abzustimmen, worin es tatsächlich gut ist, statt auf das, wozu es fähig klingt.
- Beschreiben Sie Symptome ausführlich, nicht in Stichworten. Die Genauigkeit hängt stark von der Eingabequalität ab, geben Sie also Dauer, Schweregrad und etwaige Veränderungen im Zeitverlauf an.
- Lesen Sie zuerst die Triage-Hinweise. Bei der Einschätzung der Dringlichkeit arbeitet ein KI-Symptomchecker am zuverlässigsten – achten Sie darauf, wenn er etwas als dringend markiert.
- Fragen Sie nach den Top 3, nicht nur nach der Top 1. Eine engere Auswahl an Möglichkeiten ist ehrlicher als eine einzelne, selbstsicher klingende Antwort.
- Nutzen Sie ihn, um Fragen für einen echten Termin vorzubereiten. Vage Sorge in eine konkrete Fragenliste zu verwandeln, ist einer der zuverlässigsten Einsätze des Tools.
- Überprüfen Sie alles, was wichtig ist, mit einem approbierten Arzt, besonders bei neuen, ernsten oder anhaltenden Symptomen.
- Eskalieren Sie sofort, wenn sich die Symptome verschlimmern – warten Sie nicht, bis die KI nachzieht.
- Behandeln Sie eine einzelne KI-Antwort niemals als endgültig. Gleichen Sie sie mit Ihrem tatsächlichen Befinden und mit professionellem Rat ab.
Ein KI-Diagnosetool ist meist für eine bestimmte Reihe von Aufgaben am nützlichsten und für andere am wenigsten nützlich. Bevor Sie sich darauf verlassen, hilft es zu wissen, auf welcher Seite dieser Linie Ihre Situation liegt:
- Unbekannte medizinische Begriffe aus einem Laborbefund oder Überweisungsschreiben verstehen
- Einschätzen, wie dringend ein neues Symptom sein könnte
- Eine klare Fragenliste vor einem Arztbesuch vorbereiten
- Allgemeine Gesundheitsaufklärung zu einer Erkrankung erhalten, die Sie bereits haben
- Zwischen einem Termin am selben Tag, einem geplanten Termin oder abwartendem Beobachten entscheiden
Der Konsens der Fachliteratur ist unmissverständlich: Generative KI ist ein wertvolles Hilfsmittel in Szenarien ohne Fachexpertise, kein zuverlässiger Ersatz für einen Facharzt. Die U.S. Food and Drug Administration führt KI-gestützte Medizinprodukte, die zur Vermarktung zugelassen sind, gerade deshalb, weil ungeprüfte KI-Ergebnisse ein reales klinisches Risiko bergen – eine Erinnerung daran, dass nicht nur Forscher, sondern auch Aufsichtsbehörden diese Genauigkeitslücke als bedeutsam einstufen.
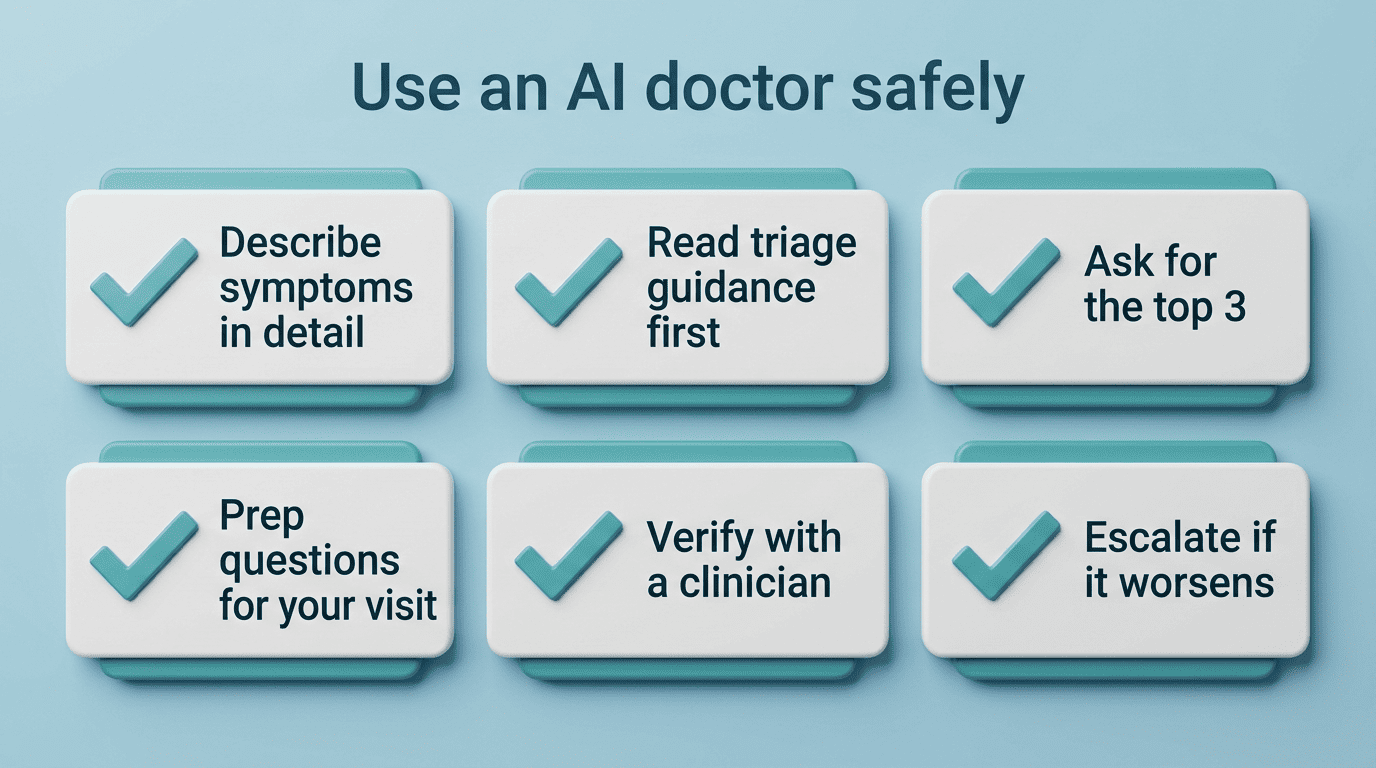
Nutzen Sie ihn sicher: Symptome vollständig beschreiben, zuerst die Triage lesen, nach den Top 3 fragen und alles Ernste mit einem Arzt überprüfen.
Wann Sie die KI überspringen und einen echten Arzt aufsuchen sollten
Ein KI-Arzt ist kein Ersatz für einen approbierten Arzt und stellt keine Diagnose. Bei medizinischen Notfällen wählen Sie 911.
Kein Genauigkeitsprozentsatz – weder 52 % noch 97 % unter idealen Bedingungen – macht ein KI-Diagnosetool sicher genug, um sich bei einem ernsten, plötzlichen oder sich verschlimmernden Symptom darauf zu verlassen. Überspringen Sie die KI und gehen Sie bei Symptomen wie den folgenden direkt zu einem echten Arzt oder in die Notfallversorgung:
- Brustschmerzen oder Druck auf der Brust oder Atemnot
- Ein plötzlicher, heftiger Kopfschmerz, wie Sie ihn noch nie zuvor hatten
- Unkontrollierbare Blutung oder eine sich rasch verschlimmernde Verletzung
- Anzeichen eines Schlaganfalls – hängender Mundwinkel, Armschwäche, verwaschene Sprache
- Jedes Symptom, das sich schlicht wie ein Notfall anfühlt
Nutzen Sie einen KI-Gesundheitsassistenten, um sich zu informieren und Ihre Gedanken zu ordnen, und überlassen Sie dann einem approbierten Arzt die eigentliche Entscheidung.
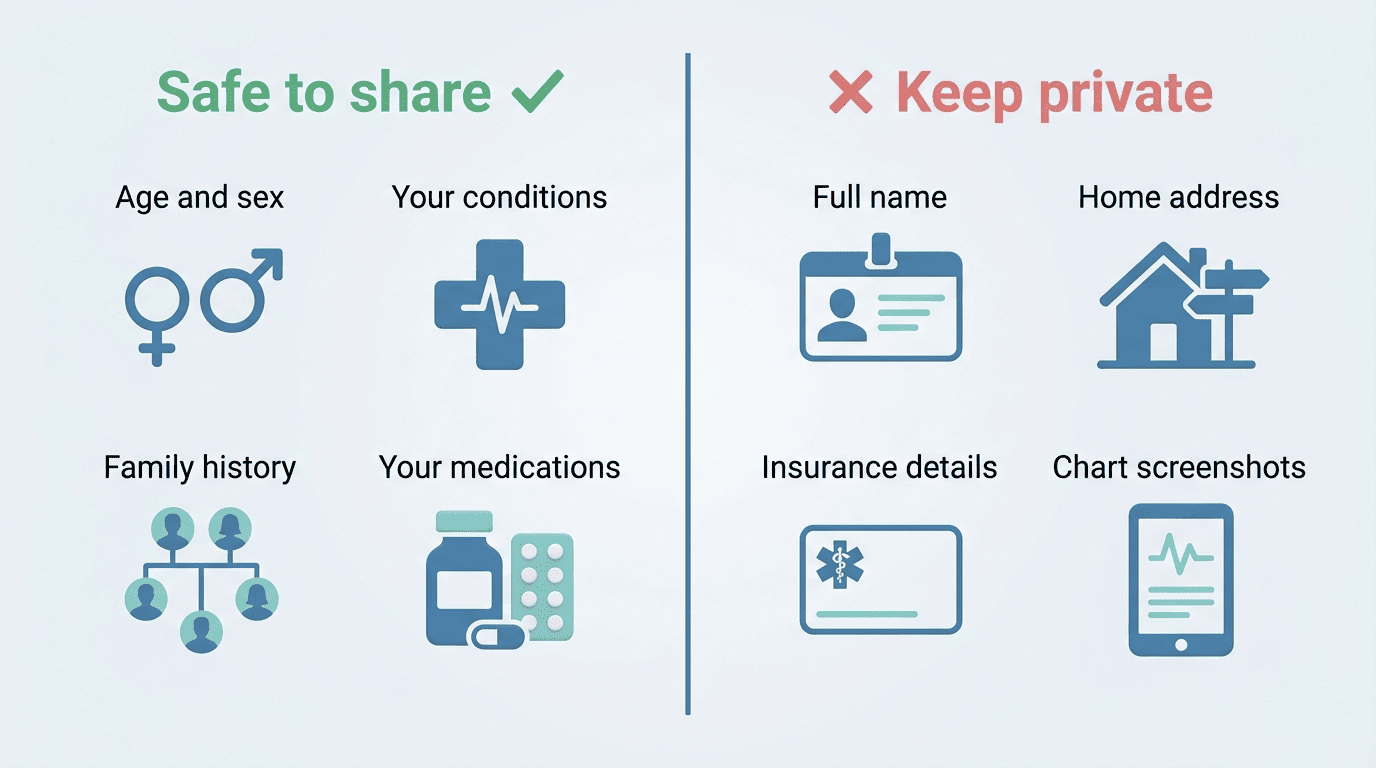
Keine Genauigkeitszahl macht KI bei Warnsignalen sicher – Brustschmerzen, Schlaganfall-Anzeichen oder starke Blutungen bedeuten: 911 wählen.