Yapay Zeka Doktoru Ne Kadar Doğru? Dürüst Sayılar
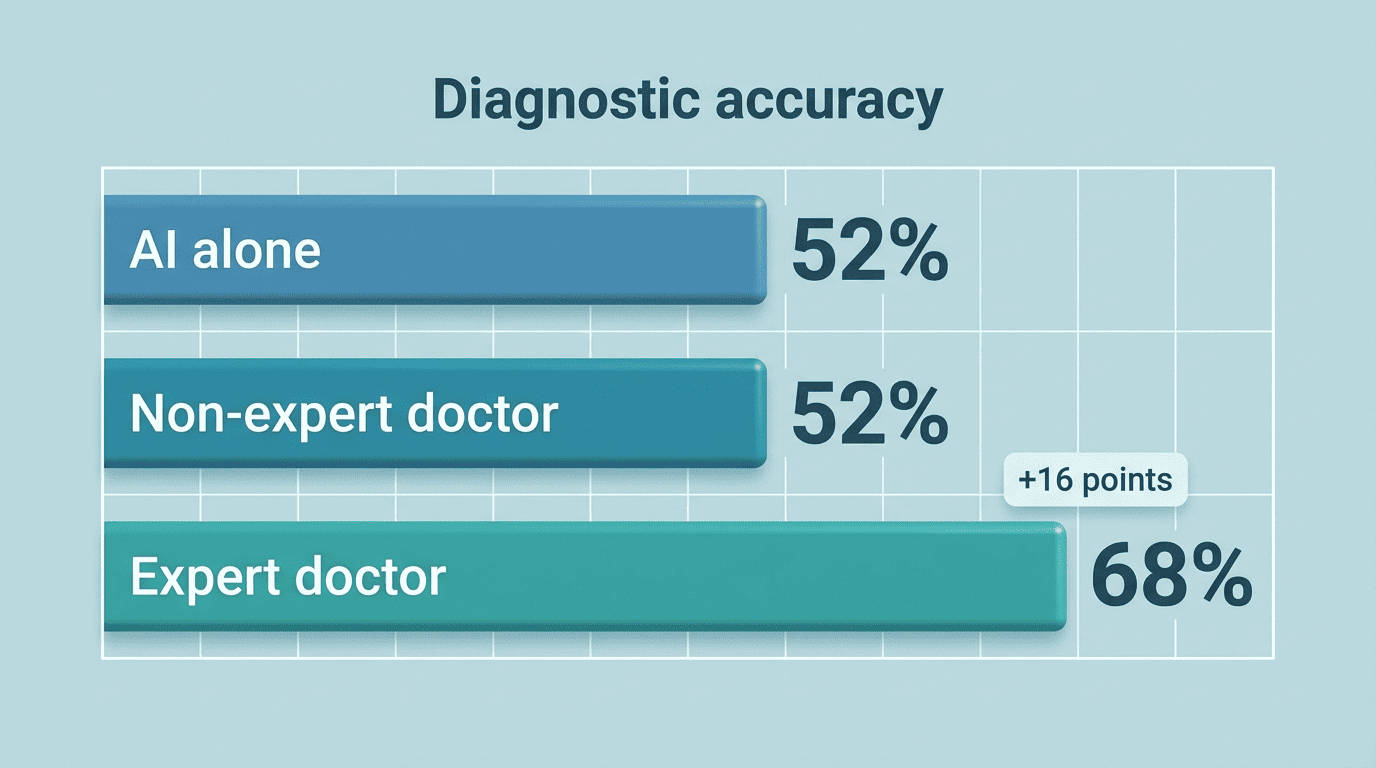
Dürüst cevap: yapay zeka doktoru, yaygın sorunlarda kabaca uzman olmayan bir hekim kadar doğrudur, ancak bir uzmanın açıkça gerisinde kalır. npj Digital Medicine dergisinde 2025 yılında yayımlanan büyük bir meta-analiz, bağımsız üretken yapay zekanın tanısal doğruluğunu yaklaşık %52 olarak belirledi. Bir çevrimiçi yapay zeka doktoru, bir hüküm değil, iyi bilgilenmiş bir ikinci görüş olarak ele alınmalıdır.
Bir yapay zeka doktoru, lisanslı bir hekimin yerini tutmaz ve tanı koymaz. Tıbbi aciliyetlerde 911’i arayın. Aşağıdaki doğruluk sayıları, onun ne işe yaradığını — ve tam olarak nerede hâlâ gerçek bir doktora ihtiyaç duyduğunuzu — açıklıyor.
Kısa Cevap: Bir Yapay Zeka Doktoru Gerçekte Ne Kadar Doğru
Pazarlamayı bir kenara bıraktığınızda tablo basit: üretken bir yapay zeka tanı aracı, tek başına kullanıldığında doğru cevabı ancak yarısından biraz fazla veriyor — ve bu tek rakam, göreve, girdi kalitesine ve neyle karşılaştırıldığına göre büyük bir değişkenliği gizliyor.
Aklınızda tutulacak bir sayı: ~%52
npj Digital Medicine dergisinde yayımlanan, 83 çalışmayı kapsayan 2025 tarihli bir sistematik derleme ve meta-analiz, üretken yapay zeka modellerinin tek başlarına çalışırken %52,1’lik (95% GA 47,0–57,1%) genel bir tanısal doğruluğa ulaştığını buldu. Bu düşük geliyor, ama kolay ve çok zor vakaların bir arada toplandığı bir ortalama — sayının etrafındaki bağlam, sayının kendisinden daha önemli.
Gerçek bir doktorla karşılaştırıldığında
Aynı meta-analiz, genel olarak yapay zeka ile hekimler arasında istatistiksel olarak anlamlı bir fark bulmadı (p=0,10) ve uzman olmayan ya da asistan hekimlere karşı da anlamlı bir fark bulunmadı (p=0,93). Ancak yapay zeka, uzman hekimlerden anlamlı derecede daha kötü performans gösterdi — yaklaşık 15,8 yüzde puanı (p=0,007). Açıkça söylemek gerekirse: bir yapay zeka semptom denetleyicisi, eğitimini yeni bitirmiş bir pratisyen hekimle kıyaslanabilir ve yılların örüntü tanıma deneyimine sahip bir uzmanın açıkça gerisindedir — ve bir yapay zeka doktorunu gerçek bir doktorla karşılaştırmak yan yana koyulduğunda, vaka zorlaştıkça bu açığın giderek genişlediğini gösteriyor.
Doğruluk Sayısı Neden Bu Kadar Çok Değişiyor
Başlıkları karşılaştıran herkes çılgınca farklı rakamlar fark edecektir — bir çalışmada %97, bir başkasında %40. Bu dağılım çoğunlukla, başlığın kendisinde nadiren belirtilen birkaç değişkene dayanıyor:
- Girdinin nasıl toplandığı — yapılandırılmış bir klinik dosya mı yoksa hastanın kendi ifadeleri mi
- “Doğru”nun tek en iyi cevap mı yoksa ilk 3-5 öneriden herhangi biri mi anlamına geldiği
- Altta yatan durumun ne kadar yaygın ya da nadir olduğu
- Hangi modelin ve sürümün, ne zaman test edildiği
- Çalışmanın tanıyı mı, triyajı mı yoksa her ikisini mi ölçtüğü
Çöp girer, çöp çıkar: girdi kalitesi her şeydir
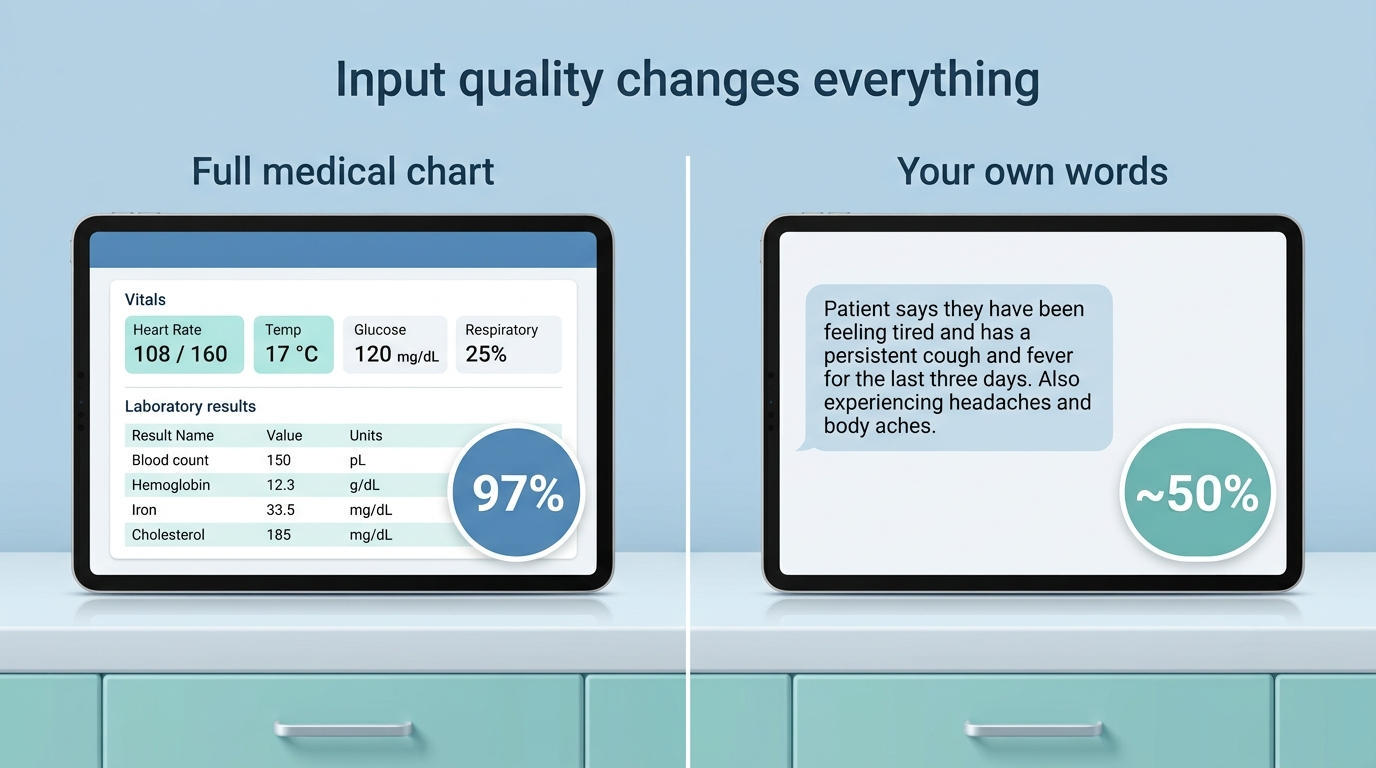
100 acil servis hastasını konu alan bir JMIR çalışmasında, GPT-4 üzerinde çalışan ChatGPT, %97 oranında doğru veya kısmen doğru tanıya ulaştı — ama yalnızca, tedavi eden doktorların kullandığı, hayati bulgular, laboratuvar sonuçları ve klinik notlar dahil, hekim tarafından hazırlanmış aynı dosyayla beslendiği için. Yalnızca hastanın ham, kendi bildirdiği semptomları verildiğinde, aynı tür modelin doğruluğu, ilk 3 eşleşmesi için kabaca %50’ye düşüyor. Yapay zeka tanı aracı, ona söylediğiniz kadar iyidir ve bir yapay zeka doktorunun nasıl çalıştığını perde arkasında anlamak, tam olarak aynı modelin neden yalnızca girdi kalitesine bağlı olarak bu kadar çok değişebildiğini açıklıyor.
İlk-1’e karşı ilk-3: hangi sayıyı aktarıyorlar?
“%70-80 doğru” iddiası genellikle, doğru cevabın yapay zeka triyaj aracının ilk üç önerisinden birinde yer aldığı anlamına gelir; doğru durumu ilk sırada adlandırdığı anlamına gelmez. Aynı sistemden tek bir cevap isteyin, doğruluk %34-40’a düşebilir. Herhangi bir yapay zeka sağlık asistanı için bir doğruluk iddiası gördüğünüzde, bunun ilk-1 mi yoksa ilk-3 mü olduğunu kontrol edin — bunlar çok farklı vaatlerdir ve satıcılar daha gurur okşayanı öne çıkarma eğilimindedir.
| Ölçüm | Tipik doğruluk | Ne anlama geldiği |
|---|---|---|
| İlk-1 (tek en iyi cevap) | %34-40 | Doğru tanı ilk sırada adlandırılmış, alternatif sunulmamış |
| İlk-3 (doğru cevap kısa listede) | %70-80 | Doğru durum 3 öneri arasında yer alıyor |
| Hekim tarafından hazırlanmış girdi (tam dosya) | %97’ye kadar | Bir doktorun kullandığı aynı yapılandırılmış verilerle beslenmiş |
| Yalnızca hasta öz-bildirimi | ~%50 (ilk-3) | Ham, yapılandırılmamış semptom tanımlarıyla beslenmiş |
Bir Yapay Zeka Doktoru Nerede Doğru — ve Nerede Başarısız
Tanısal doğruluk tek bir beceri değildir; birçok beceridir ve bir yapay zeka doktoru bazılarında diğerlerinden çok daha iyidir. Hangisinin hangisi olduğunu bilmek, aracı gerçekte nasıl kullanmanız gerektiğini değiştirir.
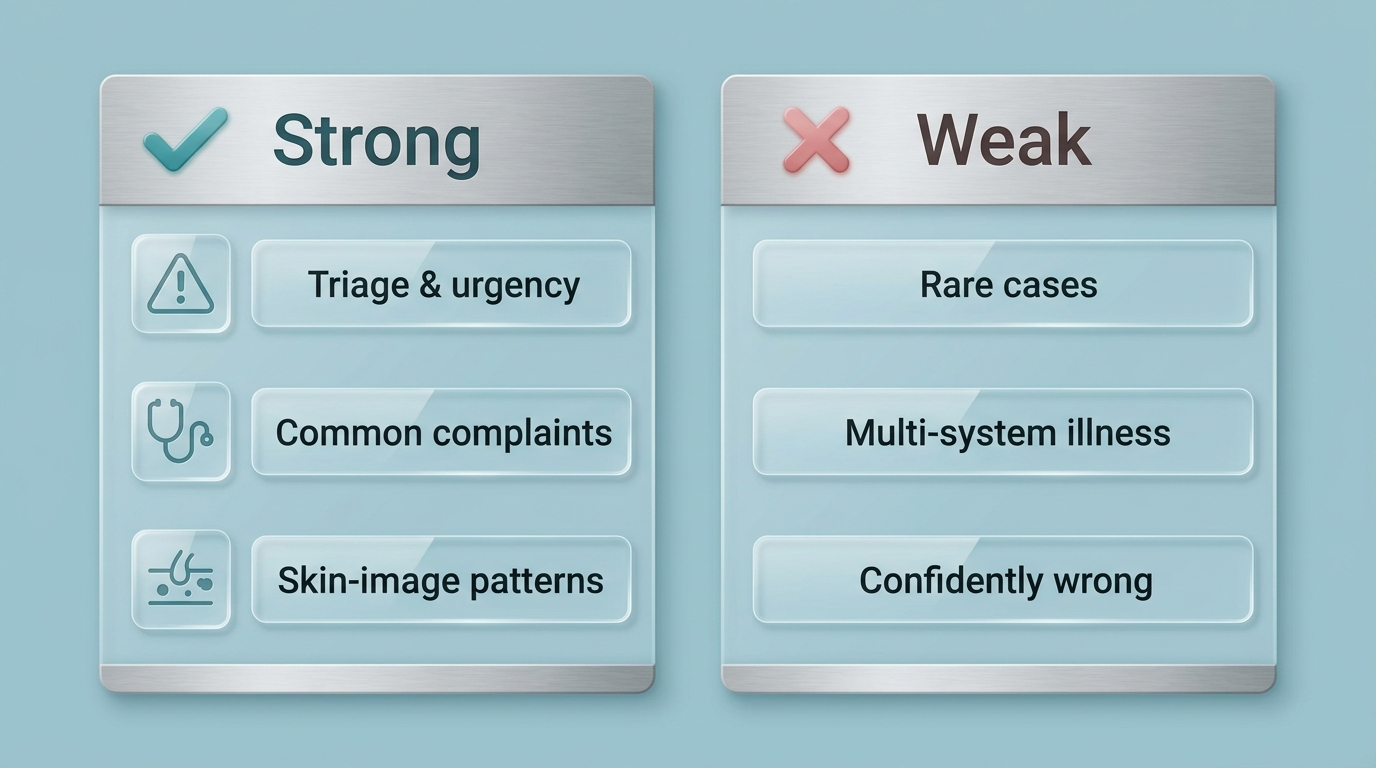
Triyajda güçlü. Bir yapay zeka doktoru en güvenilir olduğu durum, sorunun “bu ne kadar acil” olduğudur, “bu tam olarak nedir” değil. Bir semptomu acil, ivedi veya rutin olarak sınıflandırmak, nihai bir tanıya ulaşmaktan daha dar ve daha iyi tanımlanmış bir görevdir ve modeller bunu daha tutarlı yapma eğilimindedir.
Yaygın, iyi belgelenmiş şikayetlerde güçlü. Basit, sık görülen sorunlar — bol eğitim verisine ve net semptom örüntülerine sahip olanlar — üretken bir yapay zeka tanı aracının güçlü yönlerine oynar.
Dar, görüntü ağırlıklı uzmanlık alanlarında güçlü. Dermatoloji gibi örüntü tanıma görevlerinde, prospektif melanom saptama çalışmalarının bir havuzlanmış analizi, yapay zekanın tek başına yaklaşık %80,9 duyarlılık ve %75,6 özgüllüğe ulaştığını — yardım almayan dermatologlarla kıyaslanabilir olduğunu — ve yapay zeka bir dermatoloğun yerini almak yerine ona yardımcı olduğunda kabaca %91,9 duyarlılık ve %83,7 özgüllüğe yükseldiğini buldu. İyi tanımlanmış görsel örüntü sorunları, aracın kendi sahasına yakındır.
Karmaşık, nadir veya çok sistemli vakalarda zayıf. Semptomlar vücut sistemleri arasında örtüştüğünde veya nadir bir duruma işaret ettiğinde doğruluk keskin biçimde düşer — tam da bir uzman hekimin muhakemesinin en çok önem taşıdığı yerde.
Gözden kaçması kolay bir biçimde zayıf: kendinden emin yanlışlık. Bir yapay zeka doktoru, yanlış bir tanıyı akıcı, güven verici bir dille, kuşkuya işaret eden görünür bir çekince olmadan ifade edebilir. Makul görünen bir sonuç, doğru bir sonuçla aynı şey değildir; işte bu yüzden insan denetimi hâlâ önem taşır.
Çalışmalara Güvenebilir misiniz? Küçük Yazıları Okuyun
Yukarıdaki cesaret verici sayılar bile, onları tartmadan önce bilmeye değer uyarılarla birlikte gelir.
83 çalışmalık meta-analizde, 83 çalışmanın 63’ü — %76’sı — yüksek yanlılık riski taşıyor olarak derecelendirildi ve yazarlar istatistiksel olarak anlamlı yayın yanlılığı (p=0,045) işaret etti; bu, gurur okşayan sonuçların yayımlanan literatürde büyük olasılıkla aşırı temsil edildiği anlamına geliyor. Başlıklara konu olan %97’lik acil servis sonucu, yalnızca 100 hastalık tek bir çalışmadan geldi ve bulgunun büyük ölçekte geçerli olacağını doğrulayacak önceden planlanmış bir örneklem büyüklüğü hesaplaması yoktu.
| Sınırlama | Verilerin gösterdiği | Neden önemli olduğu |
|---|---|---|
| Yanlılık riski | 83 çalışmanın 63’ü (%76) yüksek risk olarak derecelendirildi | Birçok sonuç, gerçek dünyada kullanımdan daha olumlu olabilir |
| Yayın yanlılığı | İstatistiksel olarak anlamlı (p=0,045) | Hayal kırıklığı yaratan sonuçlar içeren çalışmaların yayımlanma olasılığı daha düşüktür |
| Küçük örneklemler | Acil servis çalışması 100 hastaya dayanıyor | %97 rakamının genellenebildiğini doğrulayacak önceden planlanmış örneklem büyüklüğü yok |
| Hazırlanmış girdiye karşı ham girdi | %97 (hazırlanmış dosya) vs ~%50 (öz-bildirim) | Aynı modelin doğruluğu, girdi kalitesine bağlı olarak kabaca 47 puan değişir |
Bu araştırma bütününde tekrar eden birkaç boşluk öne çıkıyor:
- Çalışmaların çoğu yapay zekayı, karmaşık gerçek dünya konuşmalarına değil, metin tabanlı vinyetlere karşı test ediyor
- Az sayıda deneme, yanlış bir yapay zeka cevabından sonra ne olduğunu, yani sonraki zararı ölçüyor
- Örneklem büyüklükleri, başlık sayısının ima ettiği güveni destekleyecek kadar sıklıkla çok küçük
- Özgün araştırma ekibinin dışında bağımsız yineleme hâlâ nadir
O meta-analizin yazarları, kendi sayılarının ne anlama geldiği konusunda açık sözlüydü:
Üretken yapay zeka modelleri henüz uzman hekimlerin güvenilir birer alternatifi değil, ancak uzman olmayan senaryolarda değerli birer yardımcı ve tıp eğitimi görenler için eğitsel araçlar olarak hizmet edebilir.
npj Digital Medicine meta-analizi, 2025
Başlıklardaki doğruluk rakamlarını, garanti değil, iyimser tavanlar olarak görün. Küçük, yüksek yanlılık riski taşıyan bir çalışmadan alınan bir sayı, sizin özgül semptomlarınız için geçerli olacak bir sayıyla aynı şey değildir.
Doğruluğunu Göz Önünde Bulundurarak Bir Yapay Zeka Doktorunu Güvenle Nasıl Kullanmalı
Yukarıdaki sayılar ışığında, akıllıca hamle, aracı kulağa yapabilecekmiş gibi geldiği şeye değil, gerçekte iyi olduğu şeye eşleştirmektir.
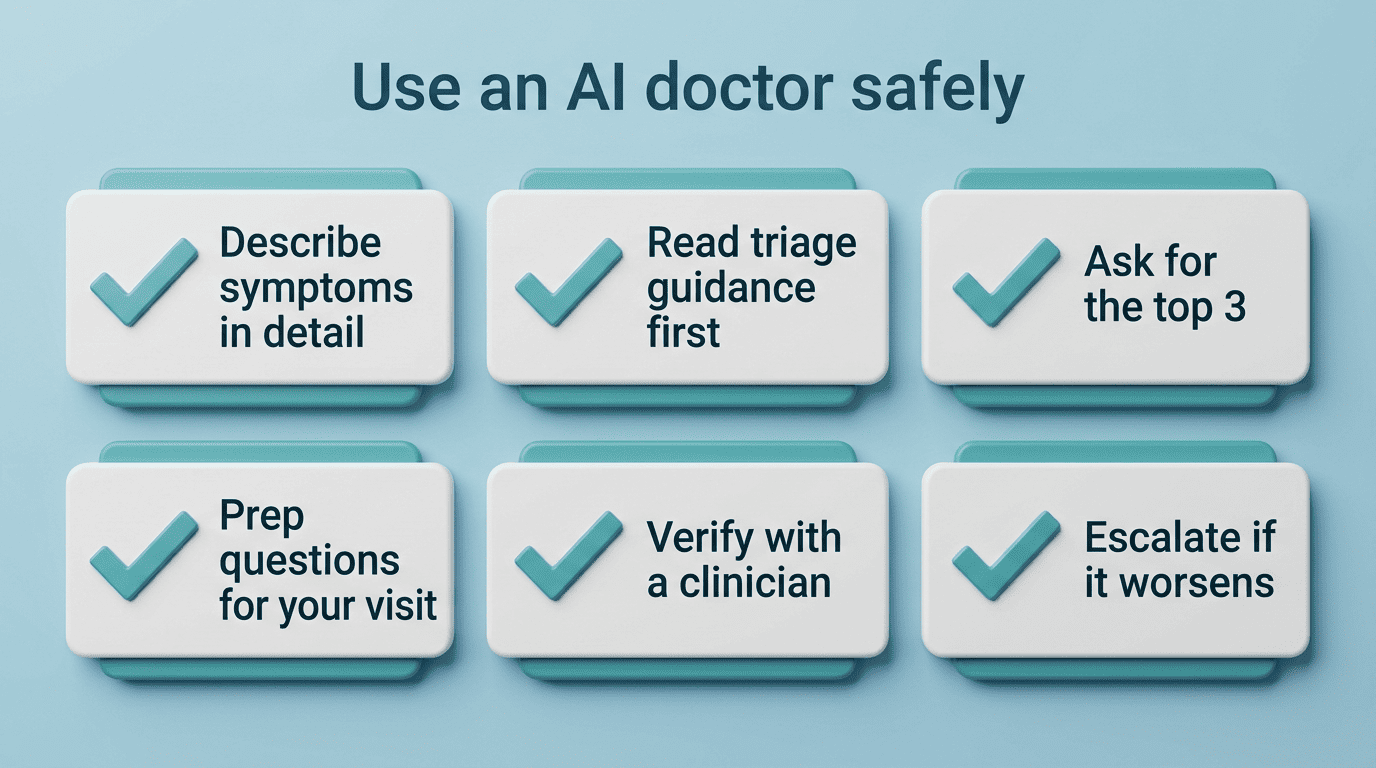
- Semptomları kısaltmalarla değil, ayrıntılı olarak tanımlayın. Doğruluk büyük ölçüde girdi kalitesine bağlıdır, bu yüzden süreyi, şiddeti ve zaman içindeki değişiklikleri belirtin.
- Önce triyaj rehberliğini okuyun. Aciliyet değerlendirmesi, bir yapay zeka semptom denetleyicisinin en güvenilir performans gösterdiği yerdir — bir şeyi acil olarak işaretlerse dikkat edin.
- Yalnızca ilk 1’i değil, ilk 3’ü isteyin. Olasılıkların kısa bir listesi, kendinden emin görünen tek bir cevaptan daha dürüsttür.
- Onu gerçek bir randevuya sorular hazırlamak için kullanın. Belirsiz bir endişeyi belirli bir soru listesine dönüştürmek, aracın en güvenilir kullanımlarından biridir.
- Önem taşıyan her şeyi lisanslı bir klinisyenle doğrulayın, özellikle yeni, ciddi veya kalıcı semptomlarda.
- Semptomlar kötüleşirse hemen üst düzeye taşıyın — yapay zekanın yetişmesini beklemeyin.
- Tek bir yapay zeka cevabını asla nihai olarak kabul etmeyin. Onu gerçekte nasıl hissettiğinizle ve profesyonel tavsiyeyle çapraz kontrol edin.
Bir yapay zeka tanı aracı, belirli bir dizi görev için en yararlı ve diğerleri için en az yararlı olma eğilimindedir. Birine güvenmeden önce, durumunuzun bu çizginin hangi tarafına düştüğünü bilmek yardımcı olur:
- Bir laboratuvar sonucundaki veya sevk mektubundaki yabancı tıbbi terimleri anlamak
- Yeni bir semptomun ne kadar acil olabileceğini değerlendirmek
- Bir doktor ziyaretinden önce net bir soru listesi hazırlamak
- Zaten sahip olduğunuz bir durum hakkında genel sağlık eğitimi almak
- Aynı gün ziyaret, planlanmış bir randevu veya izleyip beklemek arasında karar vermek
Hakemli uzlaşı açık: üretken yapay zeka, uzman olmayan senaryolarda değerli bir yardımcıdır, uzman bir hekimin güvenilir bir alternatifi değildir. ABD Gıda ve İlaç Dairesi’nin (FDA) pazarlanmak üzere onaylanan yapay zeka destekli tıbbi cihazları takip etmesi tam da doğrulanmamış yapay zeka çıktılarının gerçek klinik risk taşıması nedeniyledir — yalnızca araştırmacıların değil, düzenleyicilerin de bu doğruluk açığını önemli saydığının bir hatırlatıcısı.
Yapay Zekayı Atlayıp Ne Zaman Gerçek Bir Doktora Gitmeli
Bir yapay zeka doktoru, lisanslı bir hekimin yerini tutmaz ve tanı koymaz. Tıbbi aciliyetlerde 911’i arayın.
Hiçbir doğruluk yüzdesi — ne %52, ne de ideal koşullarda %97 — bir yapay zeka tanı aracını, ciddi, ani veya kötüleşen bir semptom için güvenilir kılmaz. Aşağıdaki gibi semptomlarda yapay zekayı atlayın ve doğrudan gerçek bir doktora ya da acil bakıma gidin:
- Göğüs ağrısı veya baskısı ya da nefes almada güçlük
- Öncekilerin hiçbirine benzemeyen ani, şiddetli bir baş ağrısı
- Kontrol edilemeyen kanama veya hızla kötüleşen bir yaralanma
- İnme belirtileri — yüzde sarkma, kolda güçsüzlük, peltek konuşma
- Basitçe acil bir durum gibi hissettiren herhangi bir semptom
Bir yapay zeka sağlık asistanını kendinizi bilgilendirmek ve düşüncelerinizi düzenlemek için kullanın, ardından gerçek kararı lisanslı bir klinisyenin vermesine izin verin.