Hvor nøyaktig er en AI-lege? De ærlige tallene
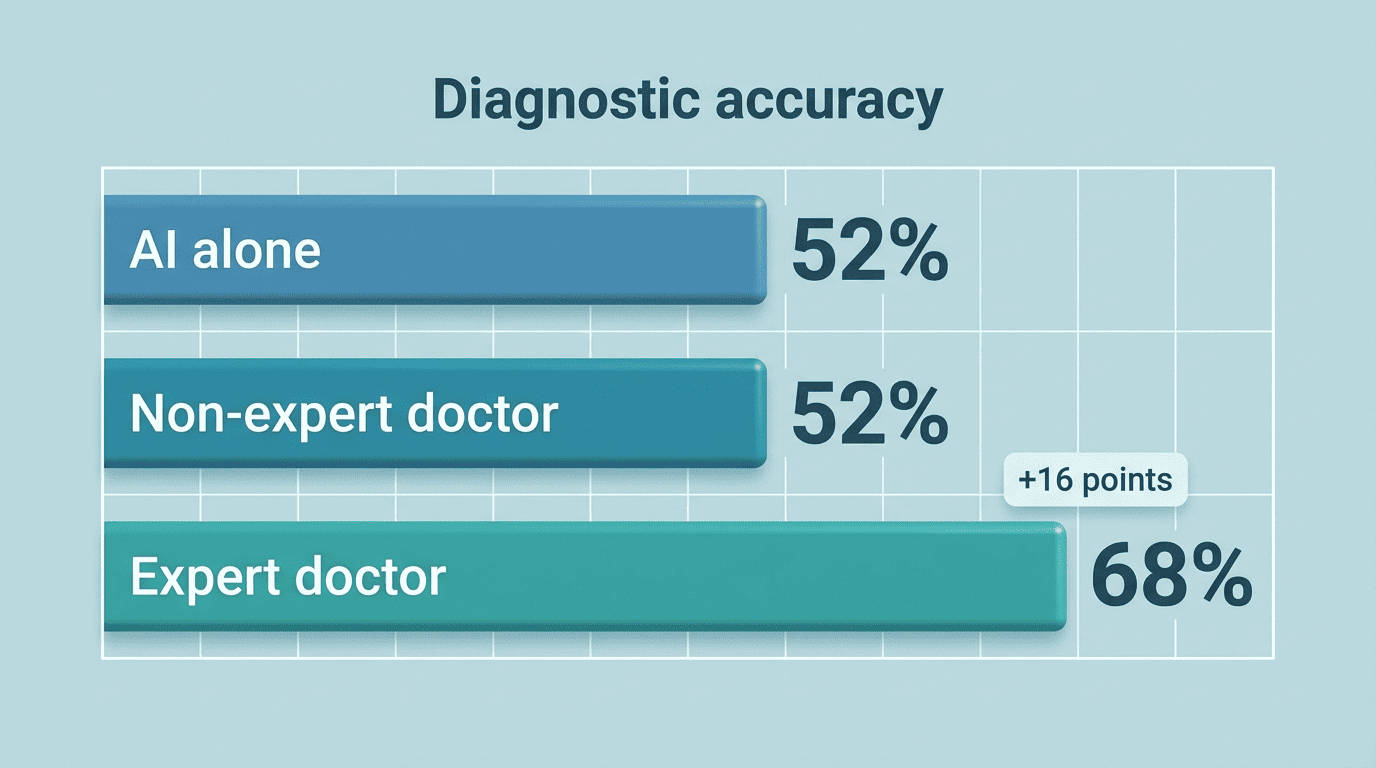
Det ærlige svaret: en AI-lege er omtrent like nøyaktig som en ikke-spesialisert lege for vanlige problemer, men den ligger tydelig bak en ekspert. En stor metaanalyse fra 2025 i npj Digital Medicine anslo den frittstående diagnostiske nøyaktigheten til generativ AI til rundt 52 %. En AI-lege på nett bør best betraktes som en velinformert andremening, ikke en dom.
En AI-lege er ikke en erstatning for en autorisert lege og stiller ingen diagnose. Ved medisinske nødstilfeller, ring 113. Nøyaktighetstallene nedenfor forklarer hva den er god til — og nøyaktig hvor du fortsatt trenger en ekte lege.
Det korte svaret: hvor nøyaktig en AI-lege egentlig er
Ta bort markedsføringen, og bildet er enkelt: et generativt AI-diagnoseverktøy, brukt på egen hånd, gir riktig svar litt mer enn halvparten av tiden — og dette ene tallet skjuler enorme variasjoner ut fra oppgave, kvaliteten på inndataene og hvem det sammenlignes med.
Ett tall å forankre seg i: ~52 %
En systematisk gjennomgang og metaanalyse av 83 studier fra 2025, publisert i npj Digital Medicine, fant at generative AI-modeller når en samlet diagnostisk nøyaktighet på 52,1 % (95 % KI 47,0–57,1 %) når de jobber på egen hånd. Det høres lavt ut, men det er et gjennomsnitt på tvers av enkle og svært vanskelige tilfeller slått sammen — konteksten rundt tallet betyr mer enn tallet selv.
Sammenlignet med en ekte lege
Den samme metaanalysen fant ingen statistisk signifikant forskjell mellom AI og leger totalt sett (p=0,10), og ingen signifikant forskjell mot ikke-ekspert- eller assistentleger (p=0,93). Men AI presterte signifikant dårligere enn ekspertleger — med omtrent 15,8 prosentpoeng (p=0,007). Enkelt sagt: en AI-symptomsjekker er sammenlignbar med en generalist rett ut av utdanningen, og ligger tydelig bak en spesialist med årevis av mønstergjenkjenning — og å sette en AI-lege sammenlignet med en ekte lege side om side viser at dette gapet øker etter hvert som tilfellet blir vanskeligere.
Hvorfor nøyaktighetstallet spriker så mye
Alle som sammenligner overskrifter, vil legge merke til vilt forskjellige tall — 97 % i én studie, 40 % i en annen. Det spriket skyldes stort sett en håndfull variabler som sjelden nevnes i selve overskriften:
- Hvordan inndataene ble samlet inn — et strukturert klinisk journal versus pasientens egne ord
- Om «riktig» betyr det ene toppsvaret eller hvilket som helst av de 3–5 øverste forslagene
- Hvor vanlig eller sjelden den underliggende tilstanden er
- Hvilken modell og versjon som ble testet, og når
- Om studien målte diagnose, triage, eller begge deler
Søppel inn, søppel ut: kvaliteten på inndataene er alt
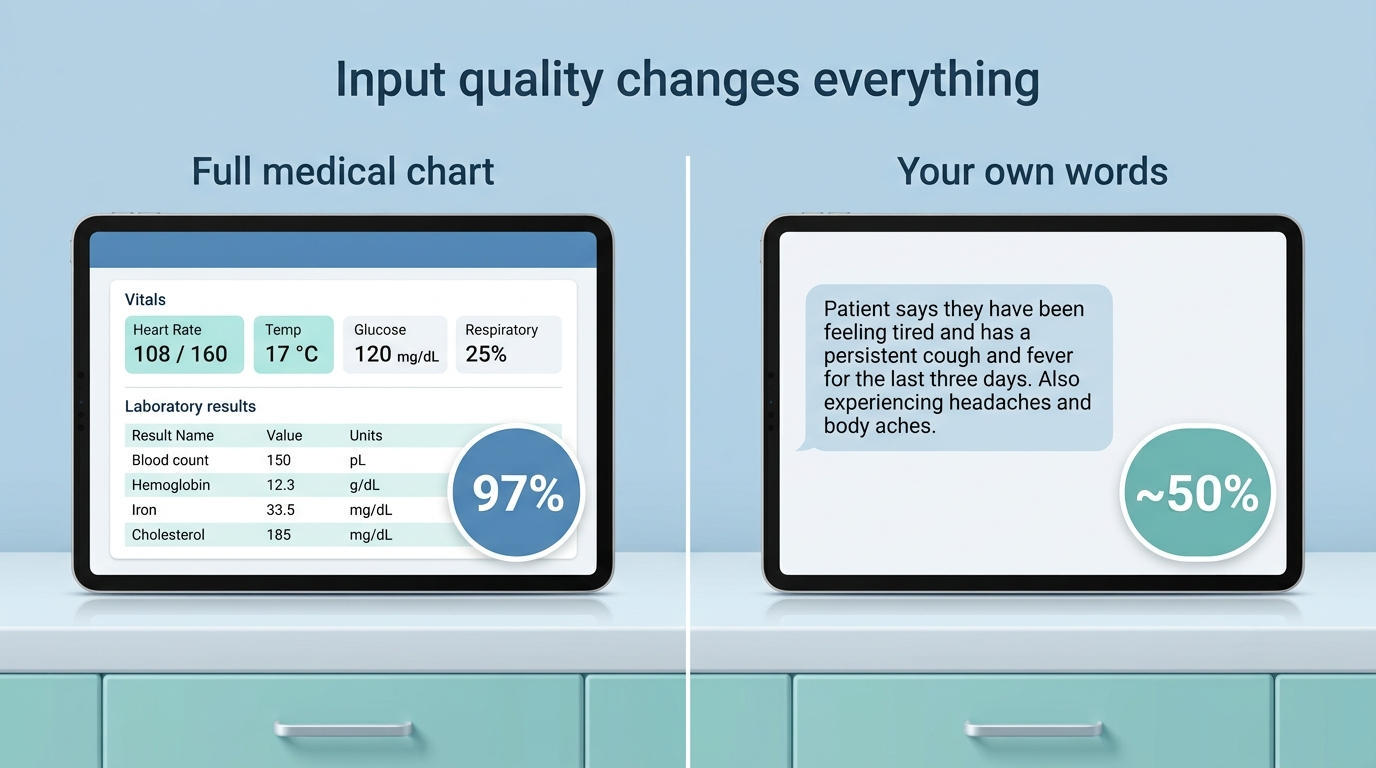
I en JMIR-studie av 100 pasienter i akuttmottak nådde ChatGPT som kjørte på GPT-4 97 % riktige eller delvis riktige diagnoser — men bare fordi den ble matet med den samme legekuraterte journalen som de behandlende legene brukte, komplett med vitale tegn, laboratorieprøver og kliniske notater. Gitt bare en pasients rå selvrapporterte symptomer faller den samme typen modells nøyaktighet til rundt 50 % for en topp-3-treff. AI-diagnoseverktøyet er bare så godt som det du forteller det, og å forstå hvordan en AI-lege fungerer under panseret forklarer hvorfor akkurat den samme modellen kan svinge så mye ut fra inndatakvaliteten alene.
Topp-1 vs topp-3: hvilket tall siterer de?
En påstand om «70–80 % nøyaktig» betyr vanligvis at det riktige svaret dukker opp et sted blant AI-triageverktøyets tre øverste forslag, ikke at det navnga den riktige tilstanden først. Be det samme systemet om ett enkelt svar, og nøyaktigheten kan falle til 34–40 %. Når du ser en nøyaktighetspåstand for en hvilken som helst AI-helseassistent, sjekk om det er topp-1 eller topp-3 — de er svært forskjellige løfter, og leverandører har en tendens til å lede med det mer smigrende av dem.
| Måling | Typisk nøyaktighet | Hva det betyr |
|---|---|---|
| Topp-1 (ett enkelt beste svar) | 34–40 % | Riktig diagnose navngitt først, ingen alternativer tilbudt |
| Topp-3 (riktig svar i kortlisten) | 70–80 % | Riktig tilstand dukker opp blant 3 forslag |
| Legekurert inndata (fullstendig journal) | Opptil 97 % | Matet med de samme strukturerte dataene en lege bruker |
| Kun pasientens egenrapport | ~50 % (topp-3) | Matet med rå, ustrukturerte symptombeskrivelser |
Hvor en AI-lege er nøyaktig — og hvor den svikter
Diagnostisk nøyaktighet er ikke én ferdighet; det er flere, og en AI-lege er mye bedre til noen enn til andre. Å vite hvilke som er hvilke endrer hvordan du faktisk bør bruke verktøyet.
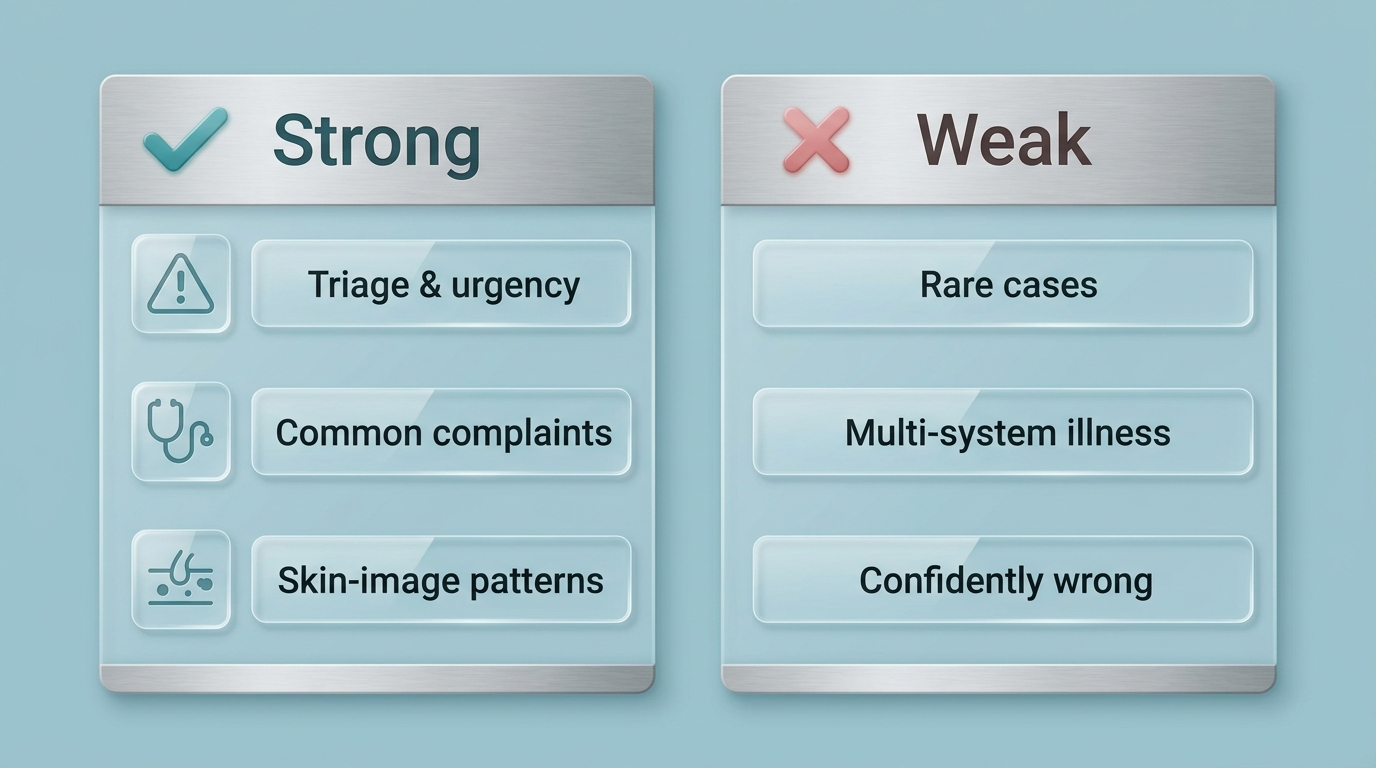
Sterk på triage. En AI-lege er mest pålitelig når spørsmålet er «hvor akutt er dette», ikke «hva er dette nøyaktig». Å sortere et symptom inn i nødsituasjon, hastende eller rutine er en smalere, bedre definert oppgave enn å nå en endelig diagnose, og modeller har en tendens til å gjøre det mer konsistent.
Sterk på vanlige, veldokumenterte plager. Enkle, ofte sette problemer — den typen med rikelig treningsdata og tydelige symptommønstre — spiller på styrkene til et generativt AI-diagnoseverktøy.
Sterk i smale, bildetunge spesialiteter. I mønstergjenkjenningsoppgaver som dermatologi fant en samlet analyse av prospektive studier på melanomdeteksjon at AI alene nådde omtrent 80,9 % sensitivitet og 75,6 % spesifisitet — sammenlignbart med dermatologer uten hjelp — og klatret til rundt 91,9 % sensitivitet og 83,7 % spesifisitet når AI bistår en dermatolog i stedet for å erstatte en. Veldefinerte visuelle mønsterproblemer er nær verktøyets hjemmebane.
Svak på komplekse, sjeldne eller flersystemtilfeller. Nøyaktigheten faller kraftig når symptomer overlapper på tvers av kroppssystemer eller peker mot en uvanlig tilstand — nettopp der en ekspertleges vurdering betyr mest.
Svak på en måte som er lett å overse: selvsikker feilaktighet. En AI-lege kan oppgi en feil diagnose i flytende, betryggende språk, uten noe synlig forbehold som signaliserer tvil. Et troverdig klingende resultat er ikke det samme som et riktig ett, og det er nettopp derfor en menneskelig kontroll fortsatt betyr noe.
Kan du stole på studiene? Les det som står med liten skrift
Selv de oppmuntrende tallene ovenfor kommer med forbehold som er verdt å kjenne til før du vektlegger dem.
I metaanalysen med 83 studier ble 63 av 83 studier — 76 % — vurdert til høy risiko for skjevhet, og forfatterne flagget statistisk signifikant publikasjonsskjevhet (p=0,045), noe som betyr at smigrende resultater sannsynligvis er overrepresentert i den publiserte litteraturen. Det overskriftsvennlige 97 %-resultatet fra akuttmottaket kom fra én enkelt studie av bare 100 pasienter, uten noen forhåndsplanlagt utvalgsstørrelsesberegning for å bekrefte at funnet ville holde i stor skala.
| Begrensning | Hva dataene viser | Hvorfor det betyr noe |
|---|---|---|
| Risiko for skjevhet | 63 av 83 studier (76 %) vurdert til høy risiko | Mange resultater kan være mer gunstige enn reell bruk ville gitt |
| Publikasjonsskjevhet | Statistisk signifikant (p=0,045) | Studier med skuffende resultater blir sjeldnere publisert |
| Små utvalg | Akuttmottaksstudien basert på 100 pasienter | Ingen forhåndsplanlagt utvalgsstørrelse for å bekrefte at 97 %-tallet generaliserer |
| Kuratert vs rå inndata | 97 % (kuratert journal) vs ~50 % (egenrapport) | Den samme modellens nøyaktighet svinger med rundt 47 poeng avhengig av inndatakvaliteten |
Noen tilbakevendende hull dukker opp på tvers av denne forskningen:
- De fleste studier tester AI mot tekstbaserte vignetter, ikke rotete samtaler fra virkeligheten
- Få forsøk måler hva som skjer etter et feil AI-svar, altså nedstrøms skade
- Utvalgsstørrelser er ofte for små til å støtte tilliten som overskriftstallet antyder
- Uavhengig replikasjon utenfor det opprinnelige forskningsteamet er fortsatt sjelden
Forfatterne av den metaanalysen var direkte om hva deres egne tall betyr:
Generative AI-modeller er ennå ikke pålitelige erstatninger for ekspertleger, men kan tjene som verdifulle hjelpemidler i ikke-ekspert-scenarier og som pedagogiske verktøy for medisinske studenter under opplæring.
npj Digital Medicine metaanalyse, 2025
Behandle nøyaktighetstall fra overskrifter som optimistiske tak, ikke garantier. Et tall hentet fra en liten studie med høy risiko for skjevhet er ikke det samme som et tall som vil holde for dine spesifikke symptomer.
Slik bruker du en AI-lege trygt gitt nøyaktigheten dens
Gitt tallene ovenfor er det smarte trekket å tilpasse verktøyet til det den faktisk er god til, snarere enn til det den høres i stand til.
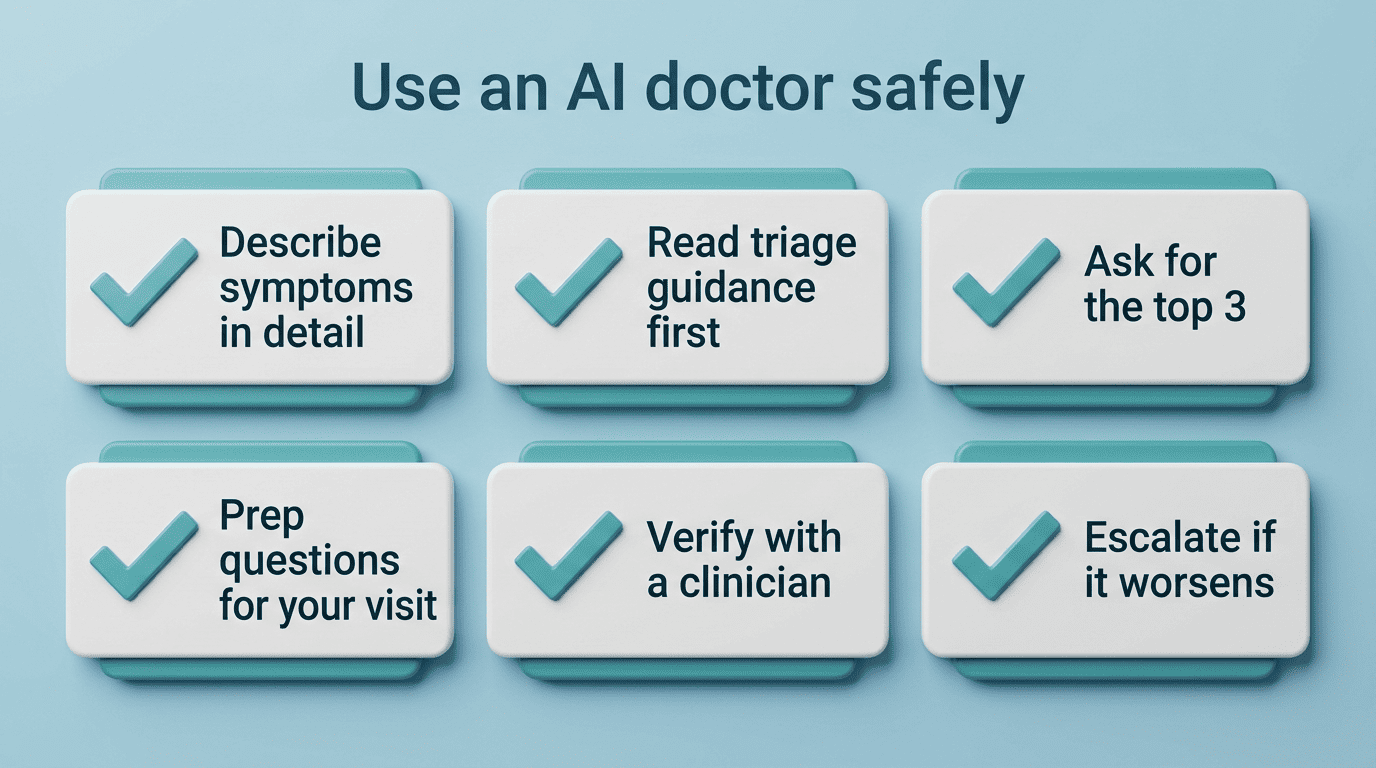
- Beskriv symptomer i detalj, ikke i stikkord. Nøyaktigheten avhenger sterkt av inndatakvaliteten, så inkluder varighet, alvorlighetsgrad og eventuelle endringer over tid.
- Les triageveiledningen først. Vurdering av hvor akutt noe er, er der en AI-symptomsjekker presterer mest pålitelig — vær oppmerksom hvis den flagger noe som hastende.
- Be om topp 3, ikke bare topp 1. En kortliste med muligheter er mer ærlig enn ett enkelt selvsikkert klingende svar.
- Bruk den til å forberede spørsmål til en ekte time. Å gjøre vag bekymring om til en spesifikk liste med spørsmål er en av verktøyets mest pålitelige bruksområder.
- Verifiser alt som betyr noe med en autorisert kliniker, særlig ved nye, alvorlige eller vedvarende symptomer.
- Eskaler umiddelbart hvis symptomene forverres — ikke vent på at AI-en tar det igjen.
- Behandle aldri ett enkelt AI-svar som endelig. Kryssjekk det mot hvordan du faktisk føler deg og mot profesjonell rådgivning.
Et AI-diagnoseverktøy har en tendens til å være mest nyttig for et bestemt sett med oppgaver og minst nyttig for andre. Før du lener deg på ett, hjelper det å vite hvilken side av den linjen din situasjon havner på:
- Å forstå ukjente medisinske begreper fra et prøvesvar eller et henvisningsbrev
- Å bedømme hvor akutt et nytt symptom kan være
- Å forberede en tydelig liste med spørsmål før et legebesøk
- Å få generell helseopplysning om en tilstand du allerede har
- Å avgjøre mellom et besøk samme dag, en planlagt time eller å vente og se
Den fagfellevurderte konsensusen er direkte: generativ AI er et verdifullt hjelpemiddel i ikke-ekspert-scenarier, ikke en pålitelig erstatning for en ekspertlege. U.S. Food and Drug Administration sporer AI-aktiverte medisinske enheter som er godkjent for markedsføring nettopp fordi uverifiserte AI-utdata bærer reell klinisk risiko — en påminnelse om at tilsynsmyndigheter, ikke bare forskere, behandler dette nøyaktighetsgapet som vesentlig.
Når du bør droppe AI-en og oppsøke en ekte lege
En AI-lege er ikke en erstatning for en autorisert lege og stiller ingen diagnose. Ved medisinske nødstilfeller, ring 113.
Ingen nøyaktighetsprosent — verken 52 % eller 97 % under ideelle forhold — gjør et AI-diagnoseverktøy trygt å stole på ved et alvorlig, plutselig eller forverrende symptom. Dropp AI-en og gå rett til en ekte lege eller akuttmedisin ved symptomer som:
- Brystsmerter eller trykk, eller pustevansker
- En plutselig, kraftig hodepine ulik noen tidligere
- Ukontrollert blødning eller en raskt forverrende skade
- Tegn på hjerneslag — hengende ansikt, armsvakhet, snøvlete tale
- Ethvert symptom som rett og slett føles som en nødsituasjon
Bruk en AI-helseassistent til å informere deg selv og organisere tankene dine, og la deretter en autorisert kliniker ta den faktiske avgjørelsen.