একজন AI ডাক্তার কতটা নির্ভুল? সৎ সংখ্যাগুলো
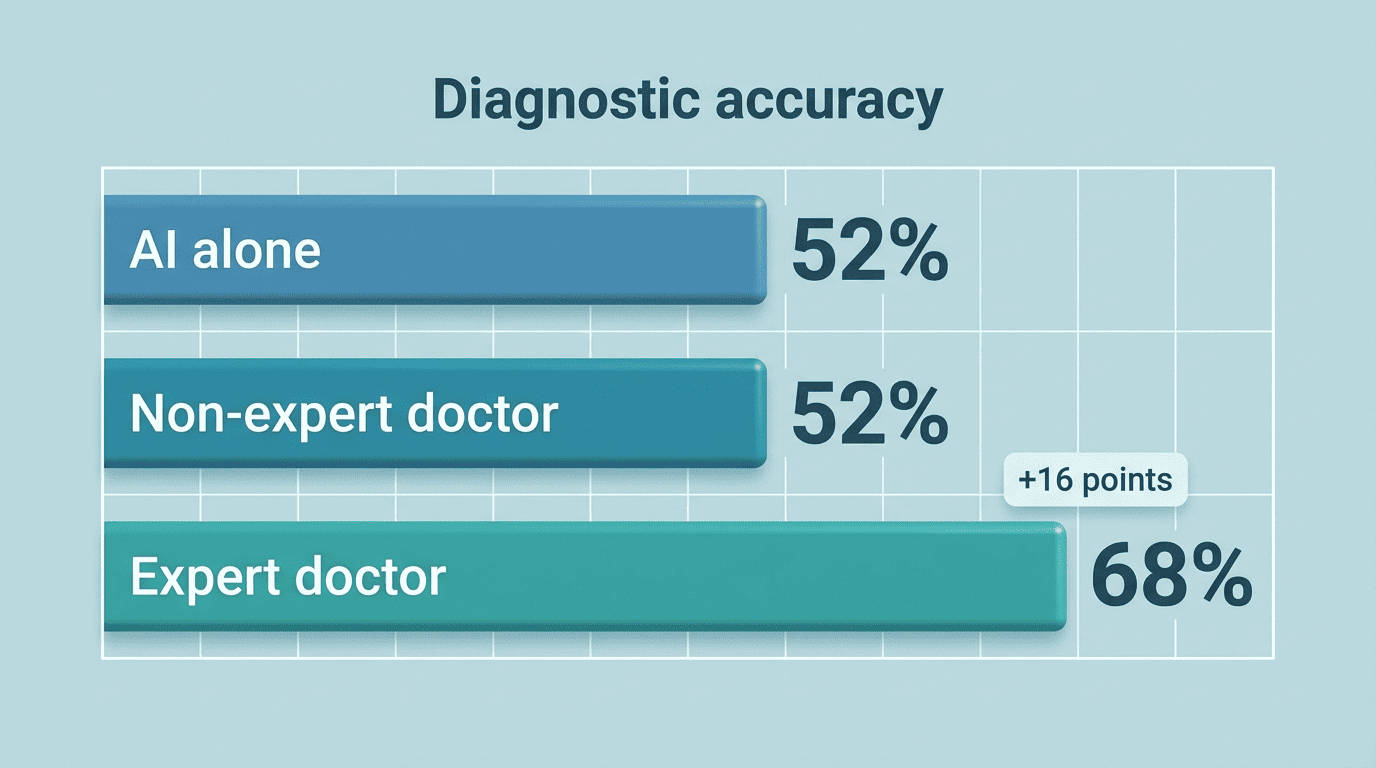
সৎ উত্তরটি হলো: সাধারণ সমস্যাগুলোর ক্ষেত্রে একজন AI ডাক্তার মোটামুটি একজন নন-স্পেশালিস্ট চিকিৎসকের মতোই নির্ভুল, কিন্তু একজন বিশেষজ্ঞের তুলনায় এটি স্পষ্টভাবেই পিছিয়ে থাকে। npj Digital Medicine-এ প্রকাশিত একটি বড় ২০২৫ সালের মেটা-বিশ্লেষণ স্বতন্ত্রভাবে জেনারেটিভ-AI-এর রোগনির্ণয়ের নির্ভুলতা প্রায় ৫২%-এ নির্ধারণ করেছে। একটি AI doctor online-কে একটি সুপঠিত সেকেন্ড ওপিনিয়ন হিসেবে বিবেচনা করাই সবচেয়ে ভালো, চূড়ান্ত রায় হিসেবে নয়।
একজন AI ডাক্তার একজন লাইসেন্সপ্রাপ্ত চিকিৎসকের বিকল্প নয় এবং এটি কোনো রোগনির্ণয় প্রদান করে না। চিকিৎসা জরুরি অবস্থার জন্য 911-এ কল করুন। নিচের নির্ভুলতার সংখ্যাগুলো ব্যাখ্যা করে এটি কীসের জন্য ভালো — এবং ঠিক কোথায় আপনার এখনও একজন প্রকৃত ডাক্তার প্রয়োজন।
সংক্ষিপ্ত উত্তর: একজন AI ডাক্তার আসলে কতটা নির্ভুল
মার্কেটিংটা সরিয়ে ফেললে ছবিটা সহজ: একটি জেনারেটিভ AI রোগনির্ণয় টুল, নিজে থেকে ব্যবহার করা হলে, অর্ধেকের চেয়ে সামান্য বেশি সময় সঠিক উত্তর দেয় — এবং এই একটিমাত্র সংখ্যা কাজ, ইনপুটের মান এবং কার সঙ্গে তুলনা করা হচ্ছে তার উপর ভিত্তি করে বিশাল ভিন্নতা লুকিয়ে রাখে।
একটি সংখ্যা যা মনে রাখা যায়: ~৫২%
npj Digital Medicine-এ প্রকাশিত ৮৩টি গবেষণার একটি ২০২৫ সালের পদ্ধতিগত পর্যালোচনা ও মেটা-বিশ্লেষণে দেখা গেছে যে জেনারেটিভ AI মডেলগুলো নিজে থেকে কাজ করার সময় সামগ্রিক রোগনির্ণয়ের নির্ভুলতা ৫২.১%-এ পৌঁছায় (95% CI 47.0–57.1%)। এটি শুনতে কম মনে হয়, কিন্তু এটি সহজ এবং অত্যন্ত কঠিন কেস একসঙ্গে জড়ো করা একটি গড় — সংখ্যাটির চেয়ে সংখ্যাটির চারপাশের প্রেক্ষাপট বেশি গুরুত্বপূর্ণ।
একজন প্রকৃত ডাক্তারের সঙ্গে তুলনা
একই মেটা-বিশ্লেষণে দেখা গেছে যে সামগ্রিকভাবে AI এবং চিকিৎসকদের মধ্যে কোনো পরিসংখ্যানগতভাবে উল্লেখযোগ্য পার্থক্য নেই (p=0.10), এবং নন-এক্সপার্ট বা রেসিডেন্ট চিকিৎসকদের বিপরীতে কোনো উল্লেখযোগ্য পার্থক্য নেই (p=0.93)। কিন্তু AI বিশেষজ্ঞ চিকিৎসকদের তুলনায় উল্লেখযোগ্যভাবে খারাপ পারফর্ম করেছে — প্রায় ১৫.৮ শতাংশ পয়েন্ট কম (p=0.007)। সহজ ভাষায়: একটি AI symptom checker সদ্য প্রশিক্ষণ শেষ করা একজন জেনারেলিস্টের সঙ্গে তুলনীয়, এবং বছরের পর বছর প্যাটার্ন শনাক্তকরণের অভিজ্ঞতাসম্পন্ন একজন বিশেষজ্ঞের তুলনায় স্পষ্টভাবেই পিছিয়ে — এবং একজন AI ডাক্তারকে একজন প্রকৃত ডাক্তারের সঙ্গে তুলনা পাশাপাশি রাখলে দেখা যায় যে কেস যত কঠিন হয়, সেই ব্যবধান তত বাড়ে।
কেন নির্ভুলতার সংখ্যাটি এত বেশি ওঠানামা করে
যে কেউ শিরোনামগুলো তুলনা করলে ব্যাপকভাবে ভিন্ন সংখ্যা লক্ষ্য করবেন — একটি গবেষণায় ৯৭%, অন্যটিতে ৪০%। সেই ব্যবধান বেশিরভাগই কয়েকটি ভেরিয়েবলের উপর নির্ভর করে যা শিরোনামে খুব কমই উল্লেখ করা হয়:
- ইনপুট কীভাবে সংগ্রহ করা হয়েছিল — একটি কাঠামোবদ্ধ ক্লিনিক্যাল চার্ট বনাম রোগীর নিজের ভাষা
- “সঠিক” মানে একটিমাত্র সেরা উত্তর নাকি শীর্ষ ৩-৫টি পরামর্শের যেকোনো একটি
- অন্তর্নিহিত অবস্থাটি কতটা সাধারণ বা বিরল
- কোন মডেল ও ভার্সন পরীক্ষা করা হয়েছিল, এবং কখন
- গবেষণাটি রোগনির্ণয়, ট্রায়াজ, নাকি উভয়ই মেপেছিল
গার্বেজ ইন, গার্বেজ আউট: ইনপুটের মানই সবকিছু
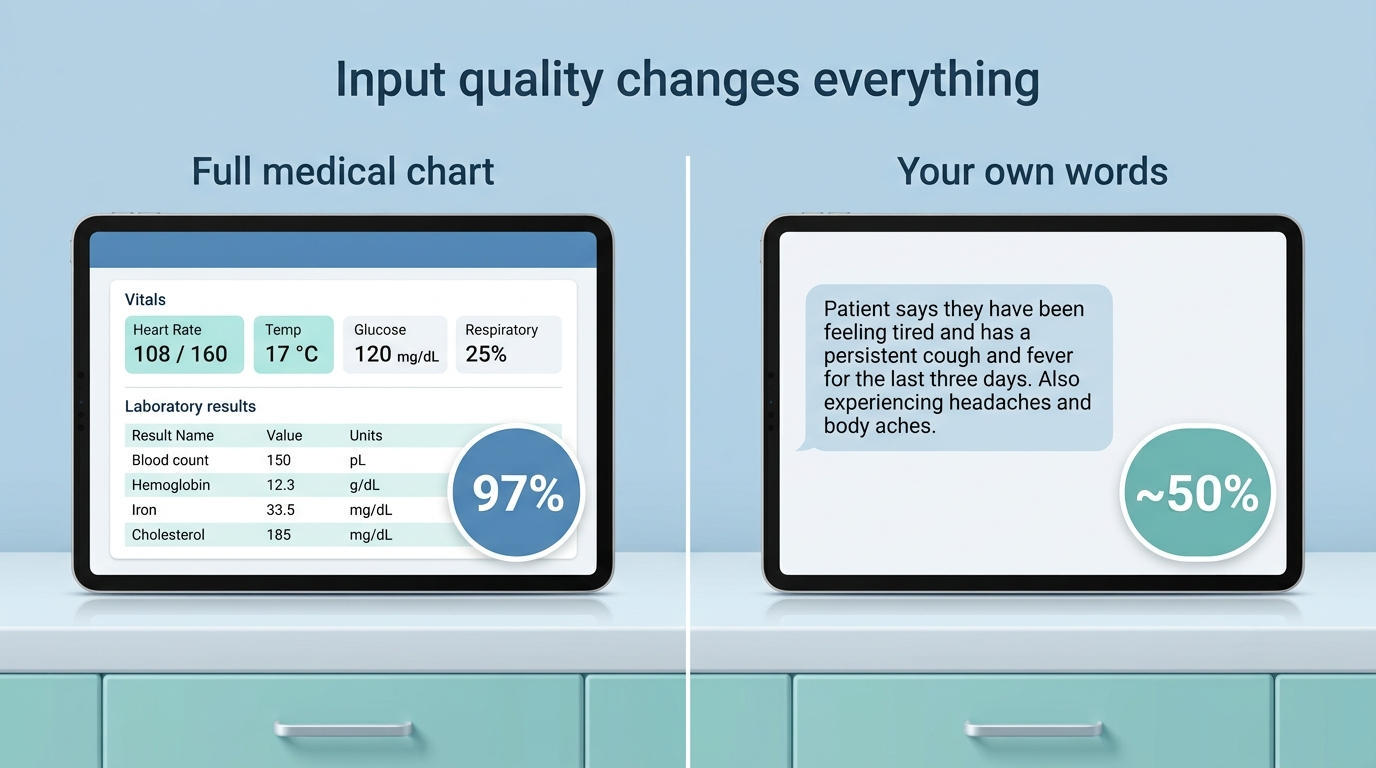
১০০ জন এমার্জেন্সি-ডিপার্টমেন্ট রোগীর উপর একটি JMIR গবেষণায়, GPT-4-তে চলা ChatGPT ৯৭% সঠিক-বা-আংশিক-সঠিক রোগনির্ণয়ে পৌঁছেছিল — কিন্তু তা কেবল এই কারণেই যে এটিকে চিকিৎসকদের ব্যবহৃত একই চিকিৎসক-নির্বাচিত চার্ট খাওয়ানো হয়েছিল, যাতে ভাইটালস, ল্যাব এবং ক্লিনিক্যাল নোট ছিল। কেবল রোগীর কাঁচা স্ব-বর্ণিত উপসর্গ দেওয়া হলে, একই ধরনের মডেলের নির্ভুলতা একটি top-3 ম্যাচের জন্য প্রায় ৫০%-এ নেমে আসে। AI রোগনির্ণয় টুলটি ঠিক ততটাই ভালো যতটা আপনি এটিকে বলেন, এবং ভেতরে একজন AI ডাক্তার কীভাবে কাজ করে তা বোঝা ব্যাখ্যা করে কেন একই মডেল কেবল ইনপুটের মানের কারণেই এত দূর পর্যন্ত দুলতে পারে।
Top-1 বনাম top-3: তারা কোন সংখ্যাটি উদ্ধৃত করছে?
“৭০-৮০% নির্ভুল” এমন একটি দাবি সাধারণত মানে হলো সঠিক উত্তরটি AI ট্রায়াজ টুলের শীর্ষ তিনটি পরামর্শের কোথাও দেখা যায়, এই নয় যে এটি সঠিক অবস্থাটির নাম প্রথমেই বলেছে। একই সিস্টেমকে একটিমাত্র উত্তর জিজ্ঞাসা করুন এবং নির্ভুলতা ৩৪-৪০%-এ নেমে যেতে পারে। যখন আপনি কোনো AI health assistant-এর জন্য একটি নির্ভুলতার দাবি দেখেন, তখন যাচাই করুন এটি top-1 নাকি top-3 — এগুলো খুবই ভিন্ন প্রতিশ্রুতি, এবং বিক্রেতারা সাধারণত বেশি চমকপ্রদটি দিয়ে শুরু করে।
| পরিমাপ | সাধারণ নির্ভুলতা | এর অর্থ কী |
|---|---|---|
| Top-1 (একটিমাত্র সেরা উত্তর) | 34-40% | সঠিক রোগনির্ণয় প্রথমে বলা হয়, কোনো বিকল্প দেওয়া হয় না |
| Top-3 (শর্টলিস্টে সঠিক উত্তর) | 70-80% | সঠিক অবস্থাটি ৩টি পরামর্শের মধ্যে দেখা যায় |
| চিকিৎসক-নির্বাচিত ইনপুট (সম্পূর্ণ চার্ট) | Up to 97% | একজন ডাক্তারের ব্যবহৃত একই কাঠামোবদ্ধ ডেটা খাওয়ানো হয় |
| শুধু রোগীর স্ব-প্রতিবেদন | ~50% (top-3) | কাঁচা, অকাঠামোবদ্ধ উপসর্গের বর্ণনা খাওয়ানো হয় |
কোথায় একজন AI ডাক্তার নির্ভুল — এবং কোথায় ব্যর্থ হয়
রোগনির্ণয়ের নির্ভুলতা একটি দক্ষতা নয়; এটি একাধিক, এবং একজন AI ডাক্তার কিছু ক্ষেত্রে অন্যগুলোর চেয়ে অনেক ভালো। কোনটি কোনটি তা জানা আপনার আসলে টুলটি কীভাবে ব্যবহার করা উচিত তা বদলে দেয়।
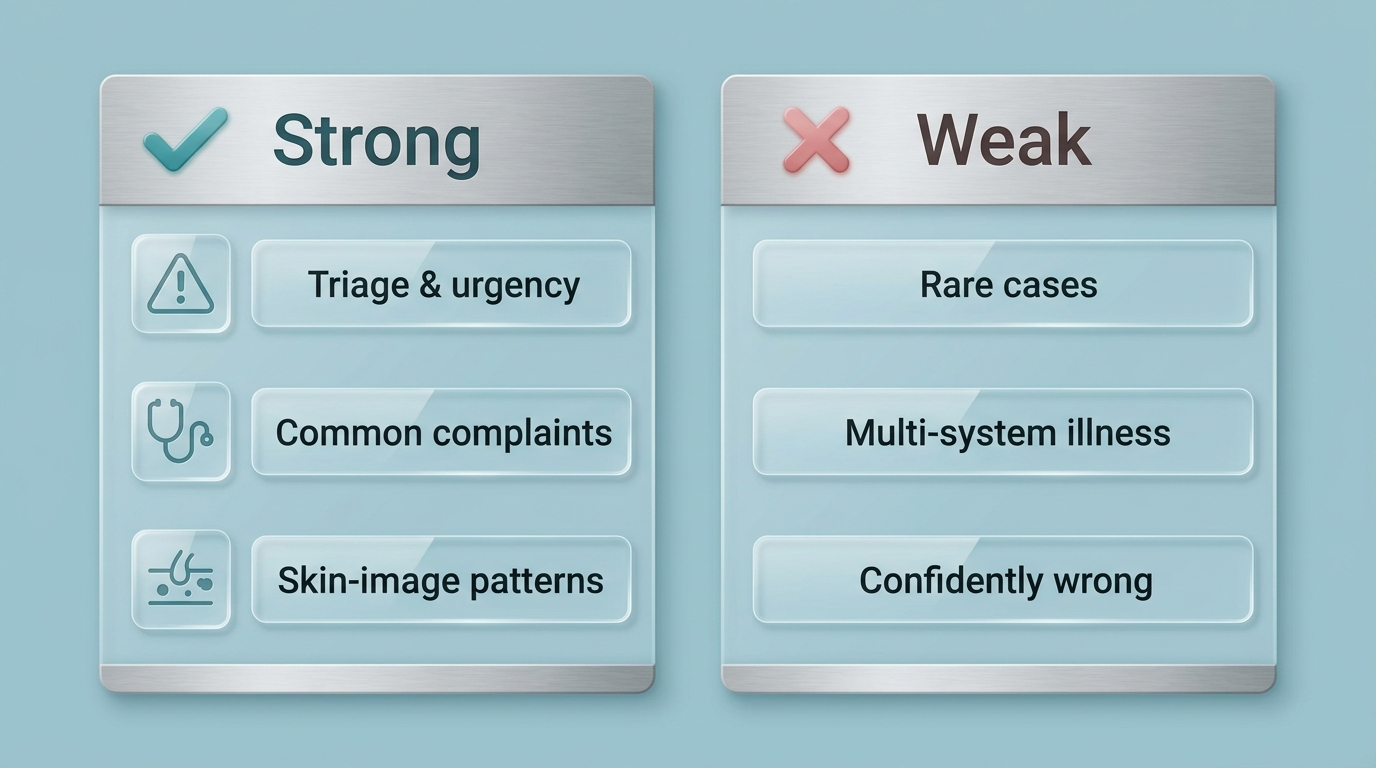
ট্রায়াজে শক্তিশালী। একজন AI ডাক্তার তখনই সবচেয়ে নির্ভরযোগ্য যখন প্রশ্নটি হয় “এটি কতটা জরুরি,” “এটি ঠিক কী” নয়। একটি উপসর্গকে এমার্জেন্সি, আর্জেন্ট, বা রুটিন-এ ভাগ করা একটি চূড়ান্ত রোগনির্ণয়ে পৌঁছানোর চেয়ে সংকীর্ণ, ভালোভাবে-সংজ্ঞায়িত কাজ, এবং মডেলগুলো এটি বেশি সামঞ্জস্যপূর্ণভাবে করার প্রবণতা রাখে।
সাধারণ, সুনথিভুক্ত অভিযোগে শক্তিশালী। সরল, প্রায়ই-দেখা সমস্যা — যেগুলোর প্রচুর ট্রেনিং ডেটা এবং স্পষ্ট উপসর্গের প্যাটার্ন থাকে — একটি জেনারেটিভ AI রোগনির্ণয় টুলের শক্তির অনুকূলে যায়।
সংকীর্ণ, ইমেজ-নির্ভর বিশেষত্বে শক্তিশালী। ডার্মাটোলজির মতো প্যাটার্ন-শনাক্তকরণ কাজে, প্রসপেক্টিভ মেলানোমা-শনাক্তকরণ গবেষণার একটি পুলড বিশ্লেষণে দেখা গেছে যে একা AI প্রায় 80.9% সেনসিটিভিটি এবং 75.6% স্পেসিফিসিটিতে পৌঁছায় — যা সহায়তাহীন ডার্মাটোলজিস্টদের সঙ্গে তুলনীয় — এবং AI যখন একজন ডার্মাটোলজিস্টকে প্রতিস্থাপন না করে সহায়তা করে তখন প্রায় 91.9% সেনসিটিভিটি এবং 83.7% স্পেসিফিসিটিতে ওঠে। ভালোভাবে-সংজ্ঞায়িত ভিজ্যুয়াল প্যাটার্ন সমস্যা টুলটির নিজের ঘরের কাছাকাছি।
জটিল, বিরল, বা মাল্টি-সিস্টেম কেসে দুর্বল। যখন উপসর্গগুলো শরীরের বিভিন্ন সিস্টেম জুড়ে ওভারল্যাপ করে বা একটি অস্বাভাবিক অবস্থার দিকে ইঙ্গিত করে তখন নির্ভুলতা তীব্রভাবে কমে যায় — ঠিক যেখানে একজন বিশেষজ্ঞ চিকিৎসকের বিচারবুদ্ধি সবচেয়ে বেশি গুরুত্বপূর্ণ।
এমনভাবে দুর্বল যা সহজেই চোখ এড়িয়ে যায়: আত্মবিশ্বাসী ভুল। একজন AI ডাক্তার সাবলীল, আশ্বস্তকারী ভাষায় একটি ভুল রোগনির্ণয় বলতে পারে, সন্দেহের কোনো দৃশ্যমান ইঙ্গিত ছাড়াই। একটি বিশ্বাসযোগ্য-শোনানো ফলাফল একটি সঠিক ফলাফলের সমান নয়, ঠিক এই কারণেই একটি মানবিক যাচাই এখনও গুরুত্বপূর্ণ।
আপনি কি গবেষণাগুলোকে বিশ্বাস করতে পারেন? ছোট অক্ষরগুলো পড়ুন
উপরের উৎসাহজনক সংখ্যাগুলোও এমন কিছু সতর্কতার সঙ্গে আসে যা ওজন করার আগে জানা মূল্যবান।
৮৩-গবেষণার মেটা-বিশ্লেষণে, ৮৩টির মধ্যে ৬৩টি গবেষণা — ৭৬% — উচ্চ পক্ষপাতের ঝুঁকিতে রেট করা হয়েছিল, এবং লেখকরা পরিসংখ্যানগতভাবে উল্লেখযোগ্য পাবলিকেশন বায়াস (p=0.045) চিহ্নিত করেছিলেন, অর্থাৎ চমকপ্রদ ফলাফলগুলো প্রকাশিত সাহিত্যে অতিরিক্তভাবে উপস্থাপিত হওয়ার সম্ভাবনা রয়েছে। শিরোনাম-দখলকারী ৯৭% এমার্জেন্সি-ডিপার্টমেন্ট ফলাফলটি এসেছিল মাত্র ১০০ জন রোগীর একটিমাত্র গবেষণা থেকে, ফলাফলটি বড় পরিসরে টিকবে কিনা তা নিশ্চিত করার জন্য কোনো পূর্ব-পরিকল্পিত স্যাম্পল-সাইজ গণনা ছাড়াই।
| সীমাবদ্ধতা | ডেটা যা দেখায় | কেন এটি গুরুত্বপূর্ণ |
|---|---|---|
| পক্ষপাতের ঝুঁকি | ৮৩টির মধ্যে ৬৩টি গবেষণা (৭৬%) উচ্চ ঝুঁকিতে রেট করা | বাস্তব-জগতের ব্যবহার যা উৎপন্ন করত তার চেয়ে অনেক ফলাফল বেশি অনুকূল হতে পারে |
| পাবলিকেশন বায়াস | পরিসংখ্যানগতভাবে উল্লেখযোগ্য (p=0.045) | হতাশাজনক ফলাফলযুক্ত গবেষণা প্রকাশিত হওয়ার সম্ভাবনা কম |
| ছোট স্যাম্পল | ED গবেষণা ১০০ জন রোগীর উপর ভিত্তি করে | ৯৭% সংখ্যাটি সাধারণীকরণ হয় কিনা তা নিশ্চিত করার জন্য কোনো পূর্ব-পরিকল্পিত স্যাম্পল সাইজ নেই |
| নির্বাচিত বনাম কাঁচা ইনপুট | 97% (নির্বাচিত চার্ট) বনাম ~50% (স্ব-প্রতিবেদন) | ইনপুটের মানের উপর নির্ভর করে একই মডেলের নির্ভুলতা প্রায় ৪৭ পয়েন্ট ওঠানামা করে |
এই গবেষণাসমূহ জুড়ে কয়েকটি পুনরাবৃত্ত ফাঁক দেখা যায়:
- বেশিরভাগ গবেষণা AI-কে টেক্সট-ভিত্তিক ভিনিয়েটের বিরুদ্ধে পরীক্ষা করে, এলোমেলো বাস্তব-জগতের কথোপকথনের বিরুদ্ধে নয়
- খুব কম ট্রায়াল মাপে যে একটি ভুল AI উত্তরের পরে কী ঘটে, অর্থাৎ পরবর্তী ক্ষতি
- স্যাম্পল সাইজ প্রায়ই শিরোনাম সংখ্যাটি যে আত্মবিশ্বাস বোঝায় তা সমর্থন করার জন্য খুব ছোট হয়
- মূল গবেষণা দলের বাইরে স্বাধীন পুনরুৎপাদন এখনও বিরল
সেই মেটা-বিশ্লেষণের লেখকরা তাদের নিজেদের সংখ্যাগুলোর অর্থ সম্পর্কে স্পষ্ট ছিলেন:
জেনারেটিভ AI মডেলগুলো এখনও বিশেষজ্ঞ চিকিৎসকদের নির্ভরযোগ্য বিকল্প নয় কিন্তু নন-এক্সপার্ট পরিস্থিতিতে মূল্যবান সহায়ক এবং মেডিকেল প্রশিক্ষণার্থীদের জন্য শিক্ষামূলক টুল হিসেবে কাজ করতে পারে।npj Digital Medicine meta-analysis, 2025
শিরোনামের নির্ভুলতার সংখ্যাগুলোকে আশাবাদী সর্বোচ্চ সীমা হিসেবে দেখুন, নিশ্চয়তা হিসেবে নয়। একটি ছোট, উচ্চ-পক্ষপাত-ঝুঁকির গবেষণা থেকে টেনে আনা একটি সংখ্যা এমন একটি সংখ্যার সমান নয় যা আপনার নির্দিষ্ট উপসর্গের জন্য টিকে থাকবে।
এর নির্ভুলতা বিবেচনায় একজন AI ডাক্তারকে নিরাপদে কীভাবে ব্যবহার করবেন
উপরের সংখ্যাগুলো বিবেচনায়, বুদ্ধিমানের কাজ হলো টুলটিকে যা এটি শুনতে সক্ষম বলে মনে হয় তার সঙ্গে নয়, বরং এটি আসলে যা ভালো পারে তার সঙ্গে মেলানো।
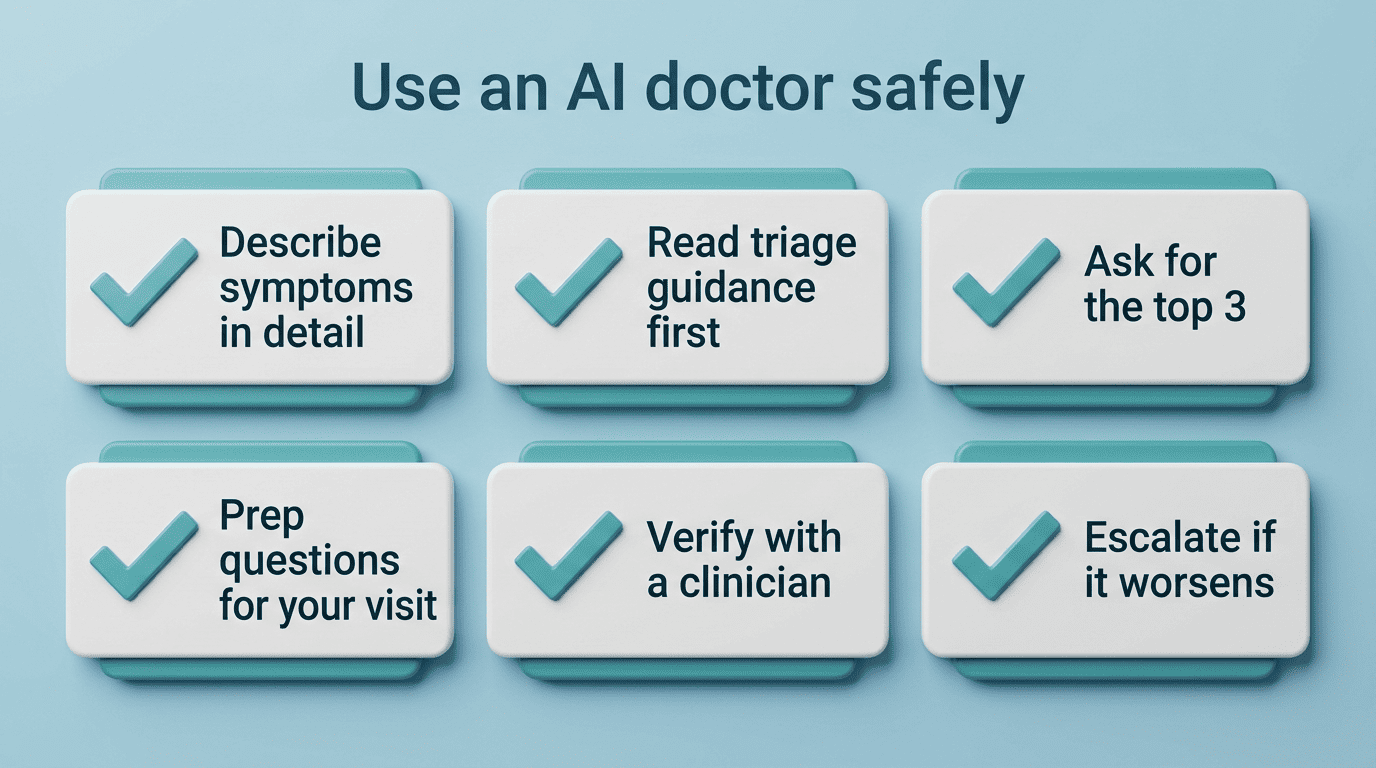
- উপসর্গগুলো সংক্ষেপে নয়, বিস্তারিতভাবে বর্ণনা করুন। নির্ভুলতা ইনপুটের মানের উপর অনেকখানি নির্ভর করে, তাই স্থায়িত্ব, তীব্রতা এবং সময়ের সঙ্গে যেকোনো পরিবর্তন অন্তর্ভুক্ত করুন।
- প্রথমে ট্রায়াজ নির্দেশনা পড়ুন। জরুরিতা মূল্যায়ন হলো যেখানে একটি AI symptom checker সবচেয়ে নির্ভরযোগ্যভাবে পারফর্ম করে — যদি এটি কিছুকে জরুরি হিসেবে চিহ্নিত করে তবে মনোযোগ দিন।
- শুধু top 1 নয়, top 3 চান। সম্ভাবনার একটি শর্টলিস্ট একটিমাত্র আত্মবিশ্বাসী-শোনানো উত্তরের চেয়ে বেশি সৎ।
- একটি প্রকৃত অ্যাপয়েন্টমেন্টের জন্য প্রশ্ন প্রস্তুত করতে এটি ব্যবহার করুন। অস্পষ্ট উদ্বেগকে একটি নির্দিষ্ট প্রশ্নের তালিকায় পরিণত করা টুলটির সবচেয়ে নির্ভরযোগ্য ব্যবহারগুলোর একটি।
- গুরুত্বপূর্ণ যেকোনো কিছু একজন লাইসেন্সপ্রাপ্ত ক্লিনিশিয়ানের সঙ্গে যাচাই করুন, বিশেষ করে নতুন, গুরুতর বা দীর্ঘস্থায়ী উপসর্গের জন্য।
- উপসর্গ খারাপ হলে অবিলম্বে এস্কেলেট করুন — AI ধরে ফেলার অপেক্ষায় থাকবেন না।
- কখনোই একটিমাত্র AI উত্তরকে চূড়ান্ত হিসেবে গণ্য করবেন না। আপনি আসলে কেমন অনুভব করছেন এবং পেশাদার পরামর্শের সঙ্গে এটি ক্রস-চেক করুন।
একটি AI রোগনির্ণয় টুল একটি নির্দিষ্ট ধরনের কাজের জন্য সবচেয়ে বেশি উপযোগী এবং অন্যগুলোর জন্য সবচেয়ে কম উপযোগী হওয়ার প্রবণতা রাখে। কোনো একটির উপর নির্ভর করার আগে, আপনার পরিস্থিতি সেই সীমারেখার কোন পাশে পড়ে তা জানা সাহায্য করে:
- একটি ল্যাব রেজাল্ট বা রেফারেল চিঠি থেকে অপরিচিত মেডিকেল পরিভাষা বোঝা
- একটি নতুন উপসর্গ কতটা জরুরি হতে পারে তা আন্দাজ করা
- একজন ডাক্তারের কাছে যাওয়ার আগে একটি স্পষ্ট প্রশ্নের তালিকা প্রস্তুত করা
- আপনার ইতিমধ্যে থাকা একটি অবস্থা সম্পর্কে সাধারণ স্বাস্থ্য শিক্ষা পাওয়া
- একই-দিনের ভিজিট, একটি নির্ধারিত অ্যাপয়েন্টমেন্ট, নাকি অপেক্ষা করে দেখার মধ্যে সিদ্ধান্ত নেওয়া
পিয়ার-রিভিউড ঐকমত্য স্পষ্ট: জেনারেটিভ AI নন-এক্সপার্ট পরিস্থিতিতে একটি মূল্যবান সহায়ক, একজন বিশেষজ্ঞ চিকিৎসকের নির্ভরযোগ্য বিকল্প নয়। U.S. Food and Drug Administration AI-সক্ষম মেডিকেল ডিভাইসগুলো ট্র্যাক করে যেগুলো মার্কেটিংয়ের জন্য অনুমোদিত ঠিক এই কারণেই যে অযাচাইকৃত AI আউটপুট প্রকৃত ক্লিনিক্যাল ঝুঁকি বহন করে — একটি স্মারক যে শুধু গবেষকরা নয়, নিয়ন্ত্রকরাও এই নির্ভুলতার ব্যবধানকে গুরুত্বপূর্ণ হিসেবে গণ্য করেন।
কখন AI বাদ দিয়ে একজন প্রকৃত ডাক্তারের কাছে যাবেন
একজন AI ডাক্তার একজন লাইসেন্সপ্রাপ্ত চিকিৎসকের বিকল্প নয় এবং এটি কোনো রোগনির্ণয় প্রদান করে না। চিকিৎসা জরুরি অবস্থার জন্য 911-এ কল করুন।
কোনো নির্ভুলতার শতাংশই — না 52%, না আদর্শ অবস্থায় ৯৭% — একটি গুরুতর, আকস্মিক বা ক্রমাবনতিশীল উপসর্গের জন্য একটি AI রোগনির্ণয় টুলকে নির্ভর করার মতো নিরাপদ করে তোলে না। এমন উপসর্গের জন্য AI বাদ দিয়ে সরাসরি একজন প্রকৃত ডাক্তার বা এমার্জেন্সি কেয়ারের কাছে যান, যেমন:
- বুকে ব্যথা বা চাপ, অথবা শ্বাস নিতে অসুবিধা
- আগের যেকোনোটির চেয়ে ভিন্ন একটি আকস্মিক, তীব্র মাথাব্যথা
- অনিয়ন্ত্রিত রক্তক্ষরণ বা দ্রুত খারাপ হতে থাকা আঘাত
- স্ট্রোকের লক্ষণ — মুখ ঝুলে পড়া, বাহুর দুর্বলতা, জড়ানো কথা
- যেকোনো উপসর্গ যা সহজভাবেই একটি জরুরি অবস্থার মতো মনে হয়
নিজেকে জানাতে এবং আপনার চিন্তাভাবনা সাজাতে একটি AI health assistant ব্যবহার করুন, তারপর একজন লাইসেন্সপ্রাপ্ত ক্লিনিশিয়ানকে প্রকৃত সিদ্ধান্ত নিতে দিন।