یک پزشک هوش مصنوعی چقدر دقیق است؟ اعداد صادقانه
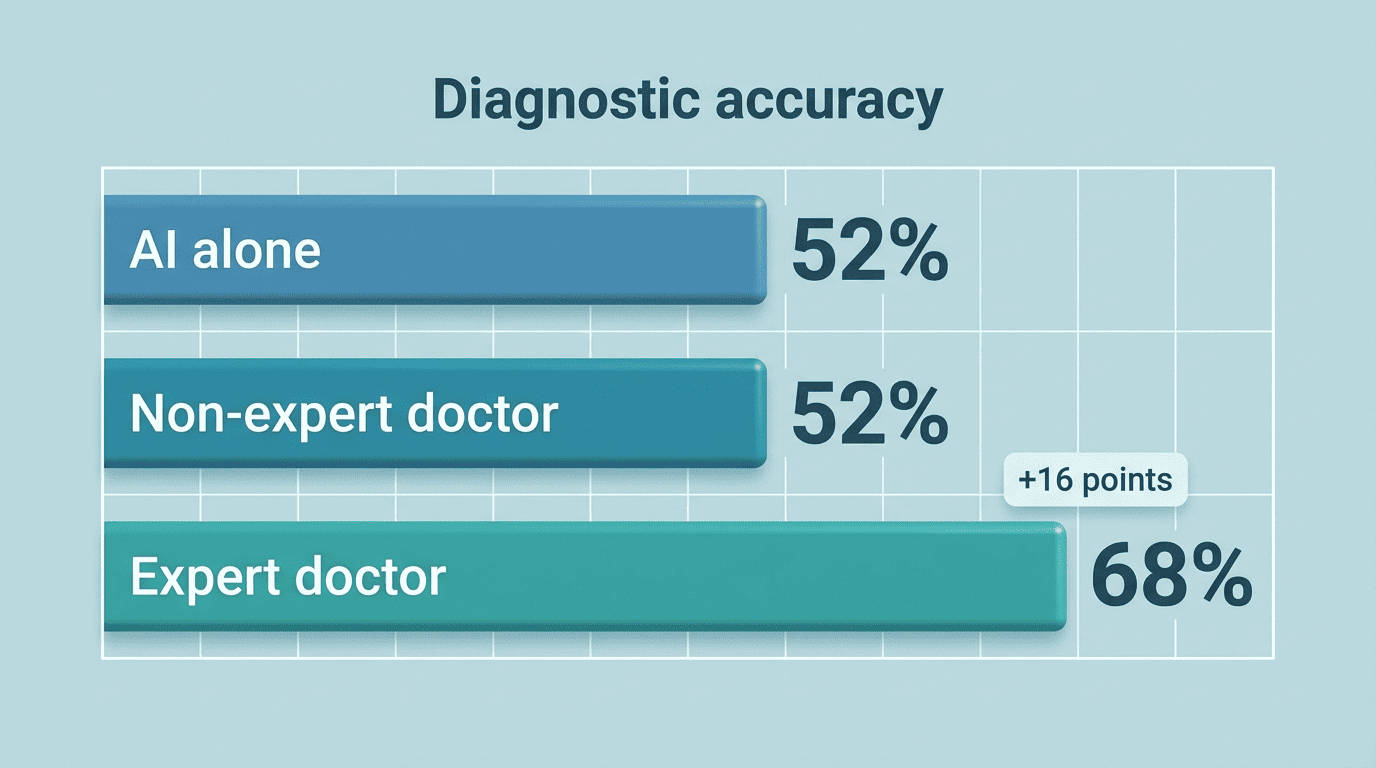
پاسخ صادقانه: یک پزشک هوش مصنوعی برای مشکلات رایج تقریباً به اندازهٔ یک پزشک غیرمتخصص دقیق است، اما بهوضوح از یک متخصص عقب میماند. یک فراتحلیل ۲۰۲۵ در npj Digital Medicine دقت تشخیصی مستقل هوش مصنوعی مولد را حدود ۵۲٪ برآورد کرد. بهترین برخورد با یک پزشک هوش مصنوعی آنلاین این است که آن را نظر دومِ یک فرد مطلع بدانید، نه یک حکم قطعی.
یک پزشک هوش مصنوعی جایگزین یک پزشک دارای مجوز نیست و تشخیص ارائه نمیدهد. در موارد اورژانس پزشکی با ۹۱۱ تماس بگیرید. اعداد دقتِ زیر توضیح میدهند که این ابزار برای چه چیزی خوب است — و دقیقاً کجا هنوز به یک پزشک واقعی نیاز دارید.
پاسخ کوتاه: یک پزشک هوش مصنوعی واقعاً چقدر دقیق است
بازاریابی را کنار بگذارید و تصویر ساده میشود: یک ابزار تشخیصی هوش مصنوعی مولد، وقتی بهتنهایی استفاده شود، کمی بیش از نیمی از مواقع پاسخ درست را میدهد — و این یک رقم واحد، تنوع عظیمی را بر اساس نوع کار، کیفیت ورودی و اینکه با چه کسی مقایسه میشود، پنهان میکند.
یک عدد برای تکیهگاه: ~۵۲٪
یک مرور نظاممند و فراتحلیل ۲۰۲۵ از ۸۳ مطالعه، که در npj Digital Medicine منتشر شد، دریافت که مدلهای هوش مصنوعی مولد وقتی بهتنهایی کار میکنند به دقت تشخیصی کلی ۵۲٫۱٪ (بازهٔ اطمینان ۹۵٪ برابر ۴۷٫۰–۵۷٫۱٪) میرسند. این پایین به نظر میرسد، اما میانگینی است از موارد آسان و بسیار دشوار که با هم تجمیع شدهاند — بافتِ پیرامون این عدد بیش از خودِ عدد اهمیت دارد.
در مقایسه با یک پزشک واقعی
همان فراتحلیل دریافت که در مجموع تفاوت آماری معناداری بین هوش مصنوعی و پزشکان وجود ندارد (p=0.10)، و تفاوت معناداری در برابر پزشکان غیرمتخصص یا دستیار وجود ندارد (p=0.93). اما هوش مصنوعی بهطور معناداری بدتر از پزشکان متخصص عمل کرد — با حدود ۱۵٫۸ واحد درصد (p=0.007). به بیان ساده: یک بررسیکنندهٔ علائم هوش مصنوعی با یک پزشک عمومیِ تازهفارغالتحصیل قابلمقایسه است، و بهوضوح از یک متخصص با سالها تجربه در تشخیص الگو عقبتر است — و قرار دادن یک پزشک هوش مصنوعی در مقایسه با یک پزشک واقعی در کنار هم نشان میدهد که با دشوارتر شدن مورد، این شکاف بیشتر میشود.
چرا عدد دقت اینقدر بالا و پایین میشود
هر کسی که تیترها را مقایسه کند متوجه ارقام بهشدت متفاوت میشود — ۹۷٪ در یک مطالعه، ۴۰٪ در مطالعهٔ دیگر. این پراکندگی عمدتاً به تعداد اندکی متغیر برمیگردد که بهندرت در خودِ تیتر ذکر میشوند:
- ورودی چگونه جمعآوری شده — یک پروندهٔ بالینی ساختارمند در برابر گفتههای خودِ بیمار
- اینکه «درست» به معنای تنها پاسخ برتر است یا هر یک از ۳ تا ۵ پیشنهاد برتر
- اینکه بیماریِ زمینهای چقدر رایج یا نادر است
- اینکه کدام مدل و نسخه آزمایش شده، و چه زمانی
- اینکه مطالعه تشخیص، دستهبندی اورژانسی (triage) یا هر دو را سنجیده است
ورودی بیکیفیت، خروجی بیکیفیت: کیفیت ورودی همهچیز است
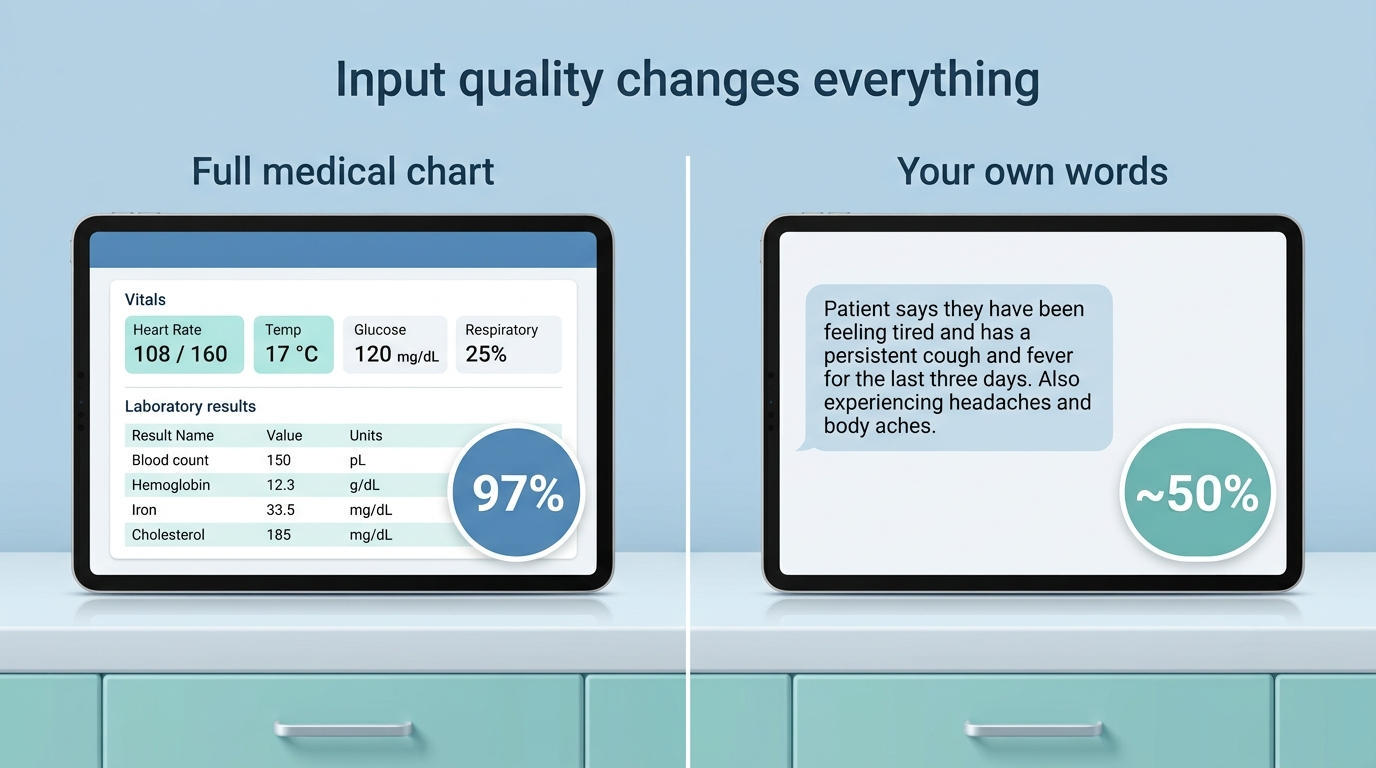
در یک مطالعهٔ JMIR روی ۱۰۰ بیمار بخش اورژانس، ChatGPT که روی GPT-4 اجرا میشد به ۹۷٪ تشخیصهای درست یا نسبتاً درست رسید — اما تنها به این دلیل که همان پروندهٔ گلچینشده توسط پزشک را که پزشکان معالج استفاده کرده بودند، همراه با علائم حیاتی، آزمایشها و یادداشتهای بالینی، دریافت کرد. اگر تنها علائم خام و خودگزارششدهٔ یک بیمار به همان نوع مدل داده شود، دقت آن برای یک تطابق در سه پاسخ برتر به حدود ۵۰٪ افت میکند. ابزار تشخیصی هوش مصنوعی فقط به اندازهٔ آنچه به آن میگویید خوب است، و درک اینکه یک پزشک هوش مصنوعی چگونه کار میکند در پشت پرده توضیح میدهد که چرا همان مدل میتواند تنها بر اساس کیفیت ورودی اینقدر نوسان کند.
سه پاسخ برتر در برابر یک پاسخ برتر: کدام عدد را نقل میکنند؟
ادعای «۷۰ تا ۸۰٪ دقیق» معمولاً به این معناست که پاسخ درست جایی در میان سه پیشنهاد برترِ ابزار دستهبندی اورژانسی هوش مصنوعی ظاهر میشود، نه اینکه بیماری درست را در همان ابتدا نام برده باشد. از همان سیستم یک پاسخ واحد بخواهید و دقت میتواند به ۳۴ تا ۴۰٪ افت کند. وقتی برای هر دستیار سلامت هوش مصنوعی یک ادعای دقت میبینید، بررسی کنید که آیا مربوط به یک پاسخ برتر است یا سه پاسخ برتر — اینها وعدههای بسیار متفاوتی هستند، و فروشندگان تمایل دارند با رقم چاپلوسانهتر آغاز کنند.
| سنجه | دقت معمول | معنای آن |
|---|---|---|
| یک پاسخ برتر (تنها بهترین پاسخ) | ۳۴ تا ۴۰٪ | تشخیص درست اول نام برده شده، هیچ گزینهٔ جایگزینی ارائه نشده |
| سه پاسخ برتر (پاسخ درست در فهرست کوتاه) | ۷۰ تا ۸۰٪ | بیماری درست در میان ۳ پیشنهاد ظاهر میشود |
| ورودی گلچینشده توسط پزشک (پروندهٔ کامل) | تا ۹۷٪ | همان دادهٔ ساختارمندی که پزشک استفاده میکند به آن داده شده |
| تنها خودگزارشیِ بیمار | ~۵۰٪ (سه پاسخ برتر) | توصیفهای خام و بدون ساختار علائم به آن داده شده |
جایی که یک پزشک هوش مصنوعی دقیق است — و جایی که شکست میخورد
دقت تشخیصی یک مهارت واحد نیست؛ چند مهارت است، و یک پزشک هوش مصنوعی در برخی از آنها بسیار بهتر از دیگران است. دانستن اینکه کدام کدام است، نحوهٔ استفادهٔ واقعی شما از این ابزار را تغییر میدهد.
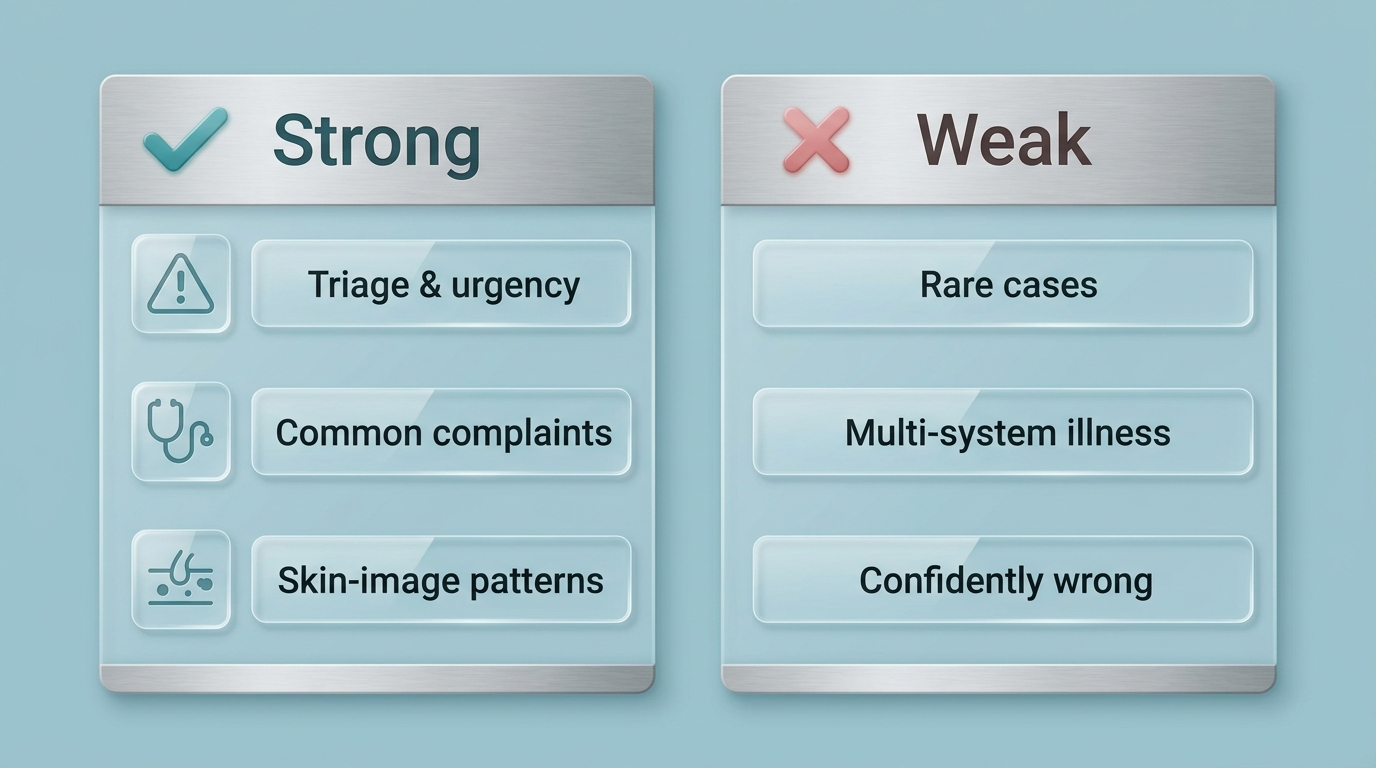
قوی در دستهبندی اورژانسی. یک پزشک هوش مصنوعی زمانی که پرسش «این چقدر فوری است» باشد، نه «این دقیقاً چیست»، قابلاعتمادترین است. مرتبکردن یک علامت در دستههای اورژانسی، فوری یا معمولی، وظیفهای محدودتر و بهتر تعریفشده نسبت به رسیدن به یک تشخیص نهایی است، و مدلها تمایل دارند آن را با ثبات بیشتری انجام دهند.
قوی در شکایتهای رایج و بهخوبی مستندشده. مشکلات سرراست و پرتکرار — از آن دست که دادهٔ آموزشی فراوان و الگوهای علامتیِ روشن دارند — به نقاط قوت یک ابزار تشخیصی هوش مصنوعی مولد میدان میدهند.
قوی در تخصصهای محدود و متکی بر تصویر. در وظایف تشخیص الگو مانند پوستپزشکی، یک تحلیل تجمیعی از مطالعات آیندهنگر تشخیص ملانوم دریافت که هوش مصنوعی بهتنهایی به حدود ۸۰٫۹٪ حساسیت و ۷۵٫۶٪ ویژگی میرسد — قابلمقایسه با پوستپزشکان بدون کمک — و وقتی هوش مصنوعی به یک پوستپزشک کمک میکند به جای آنکه جایگزین او شود، به حدود ۹۱٫۹٪ حساسیت و ۸۳٫۷٪ ویژگی میرسد. مسائل الگوی بصریِ بهخوبی تعریفشده نزدیک به قلمرو خانگیِ این ابزار هستند.
ضعیف در موارد پیچیده، نادر یا چندسیستمی. دقت بهشدت افت میکند وقتی علائم در سراسر سیستمهای بدن همپوشانی دارند یا به یک بیماری غیرمعمول اشاره میکنند — دقیقاً همان جایی که قضاوت یک پزشک متخصص بیشترین اهمیت را دارد.
ضعیف به شکلی که بهراحتی از قلم میافتد: خطای مطمئن. یک پزشک هوش مصنوعی میتواند یک تشخیص نادرست را با زبانی روان و اطمینانبخش بیان کند، بدون هیچ نشانهٔ آشکاری که تردید را برساند. یک نتیجهٔ بهظاهر باورپذیر با یک نتیجهٔ درست یکسان نیست، و دقیقاً به همین دلیل است که یک بررسی انسانی همچنان اهمیت دارد.
آیا میتوان به مطالعات اعتماد کرد؟ متن ریز را بخوانید
حتی اعداد دلگرمکنندهٔ بالا هم با ملاحظاتی همراهاند که ارزش دانستن دارند پیش از آنکه آنها را بسنجید.
در فراتحلیل ۸۳ مطالعهای، ۶۳ مطالعه از ۸۳ مطالعه — ۷۶٪ — در معرض خطر بالای سوگیری ارزیابی شدند، و نویسندگان سوگیری انتشار آماری معنادار (p=0.045) را نشان کردند، که یعنی نتایج چاپلوسانه احتمالاً در ادبیات منتشرشده بیش از حد نمایش داده شدهاند. آن نتیجهٔ ۹۷٪ بخش اورژانس که سرِ خط اخبار را میگیرد از یک مطالعهٔ واحد و تنها ۱۰۰ بیمار به دست آمد، بدون هیچ محاسبهٔ از پیشبرنامهریزیشدهٔ حجم نمونه تا تأیید کند این یافته در مقیاس بزرگتر پابرجا میماند.
| محدودیت | آنچه دادهها نشان میدهند | چرا اهمیت دارد |
|---|---|---|
| خطر سوگیری | ۶۳ مطالعه از ۸۳ مطالعه (۷۶٪) خطر بالا ارزیابی شدند | بسیاری از نتایج ممکن است مطلوبتر از آنچه استفادهٔ دنیای واقعی تولید میکند باشند |
| سوگیری انتشار | آماری معنادار (p=0.045) | مطالعات با نتایج ناامیدکننده کمتر احتمال دارد منتشر شوند |
| نمونههای کوچک | مطالعهٔ اورژانس بر پایهٔ ۱۰۰ بیمار | هیچ حجم نمونهٔ از پیشبرنامهریزیشدهای برای تأیید تعمیمپذیری رقم ۹۷٪ |
| ورودی گلچینشده در برابر خام | ۹۷٪ (پروندهٔ گلچینشده) در برابر ~۵۰٪ (خودگزارشی) | دقت همان مدل بسته به کیفیت ورودی حدود ۴۷ واحد نوسان میکند |
چند شکاف تکرارشونده در سراسر این پیکرهٔ پژوهشی نمایان میشوند:
- بیشتر مطالعات هوش مصنوعی را در برابر سناریوهای متنی آزمایش میکنند، نه گفتوگوهای درهمریختهٔ دنیای واقعی
- آزمایشهای اندکی میسنجند که پس از یک پاسخ نادرست هوش مصنوعی چه رخ میدهد، یعنی آسیب پاییندستی
- حجم نمونهها اغلب بیش از حد کوچکاند تا از اطمینانِ ضمنی در عددِ تیتر پشتیبانی کنند
- تکرار مستقل بیرون از تیم پژوهشی اصلی همچنان نادر است
نویسندگان آن فراتحلیل دربارهٔ معنای اعداد خودشان بیپرده بودند:
مدلهای هوش مصنوعی مولد هنوز جایگزینهای قابلاعتمادی برای پزشکان متخصص نیستند اما ممکن است در سناریوهای غیرتخصصی بهعنوان کمکهای ارزشمند و بهعنوان ابزارهای آموزشی برای کارآموزان پزشکی مفید باشند.
فراتحلیل npj Digital Medicine، ۲۰۲۵
با ارقام دقتِ تیتر مانند سقفهای خوشبینانه برخورد کنید، نه ضمانتها. عددی که از یک مطالعهٔ کوچک و با خطر بالای سوگیری بیرون کشیده شده، با عددی که برای علائم خاص شما پابرجا خواهد ماند یکسان نیست.
چگونه با توجه به دقتش، از یک پزشک هوش مصنوعی ایمن استفاده کنیم
با توجه به اعداد بالا، حرکت هوشمندانه این است که ابزار را با آنچه واقعاً در آن خوب است تطبیق دهید، نه با آنچه به نظر میرسد از پس آن برمیآید.
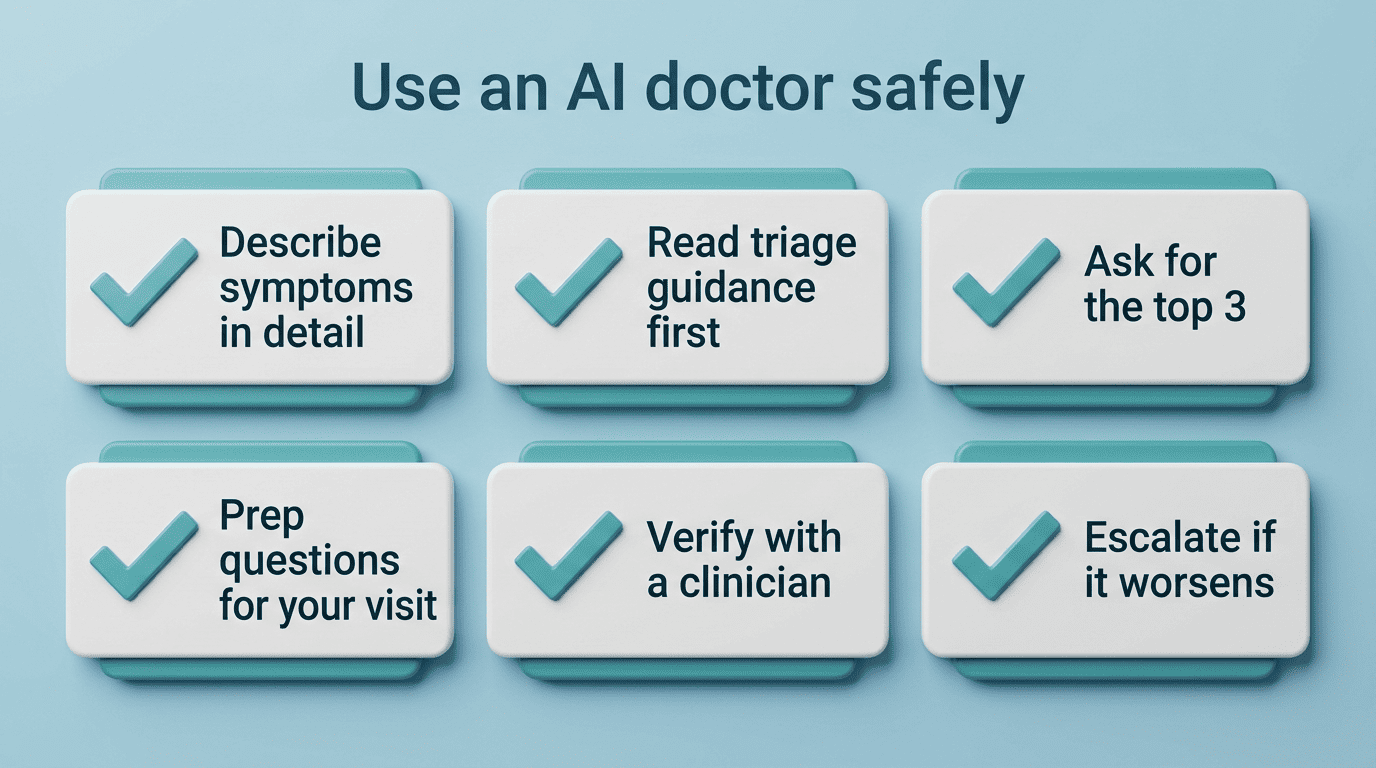
- علائم را با جزئیات توصیف کنید، نه بهصورت مختصر. دقت بهشدت به کیفیت ورودی بستگی دارد، پس مدت، شدت و هر تغییری در طول زمان را بگنجانید.
- ابتدا راهنمای دستهبندی اورژانسی را بخوانید. ارزیابی فوریت جایی است که یک بررسیکنندهٔ علائم هوش مصنوعی قابلاعتمادترین عملکرد را دارد — اگر چیزی را فوری علامتگذاری کرد، به آن توجه کنید.
- سه پاسخ برتر را بخواهید، نه فقط پاسخ برتر را. یک فهرست کوتاه از احتمالات صادقانهتر از یک پاسخ واحدِ بهظاهر مطمئن است.
- از آن برای آمادهکردن پرسشها جهت یک ملاقات واقعی استفاده کنید. تبدیل نگرانی مبهم به یک فهرست مشخص از پرسشها یکی از قابلاعتمادترین کاربردهای این ابزار است.
- هر چیز مهمی را با یک پزشک دارای مجوز راستیآزمایی کنید، بهویژه برای علائم جدید، جدی یا پایدار.
- اگر علائم بدتر شد بیدرنگ اقدام کنید — منتظر نمانید تا هوش مصنوعی خودش را برساند.
- هرگز یک پاسخ واحد هوش مصنوعی را نهایی تلقی نکنید. آن را با احساس واقعی خودتان و با توصیهٔ حرفهای مقایسه کنید.
یک ابزار تشخیصی هوش مصنوعی تمایل دارد برای مجموعهٔ خاصی از وظایف بیشترین سودمندی و برای وظایف دیگر کمترین سودمندی را داشته باشد. پیش از تکیه بر یکی از آنها، دانستن اینکه موقعیت شما در کدام سوی این خط قرار میگیرد کمک میکند:
- فهمیدن اصطلاحات پزشکی ناآشنا از یک نتیجهٔ آزمایش یا نامهٔ ارجاع
- سنجش اینکه یک علامت جدید چقدر ممکن است فوری باشد
- آمادهکردن یک فهرست روشن از پرسشها پیش از مراجعه به پزشک
- گرفتن آموزش سلامت عمومی دربارهٔ بیماریای که از قبل دارید
- تصمیمگیری میان یک مراجعهٔ همانروز، یک ملاقات برنامهریزیشده یا انتظار هوشیارانه
اجماع داوریشده بیپرده است: هوش مصنوعی مولد یک کمک ارزشمند در سناریوهای غیرتخصصی است، نه یک جایگزین قابلاعتماد برای یک پزشک متخصص. سازمان غذا و داروی ایالات متحده دستگاههای پزشکی مجهز به هوش مصنوعی را ردیابی میکند که برای عرضه به بازار تأیید شدهاند، دقیقاً به این دلیل که خروجیهای راستیآزمایینشدهٔ هوش مصنوعی خطر بالینی واقعی به همراه دارند — یادآوری اینکه قانونگذاران، نه فقط پژوهشگران، این شکاف دقت را جدی میگیرند.
چه زمانی از هوش مصنوعی بگذریم و به یک پزشک واقعی مراجعه کنیم
یک پزشک هوش مصنوعی جایگزین یک پزشک دارای مجوز نیست و تشخیص ارائه نمیدهد. در موارد اورژانس پزشکی با ۹۱۱ تماس بگیرید.
هیچ درصد دقتی — نه ۵۲٪، نه ۹۷٪ در شرایط ایدهآل — یک ابزار تشخیصی هوش مصنوعی را برای تکیهکردن بر آن در یک علامت جدی، ناگهانی یا رو به وخامت ایمن نمیکند. برای علائمی مانند موارد زیر، از هوش مصنوعی بگذرید و مستقیم به یک پزشک واقعی یا مراقبت اورژانسی بروید:
- درد یا فشار در قفسهٔ سینه، یا دشواری در تنفس
- یک سردرد ناگهانی و شدید که با هیچ سردرد پیشینی شبیه نیست
- خونریزی کنترلنشده یا یک جراحت که بهسرعت رو به وخامت است
- علائم سکته — افتادگی صورت، ضعف بازو، لکنت گفتار
- هر علامتی که صرفاً حس یک اورژانس را میدهد
از یک دستیار سلامت هوش مصنوعی برای آگاهکردن خود و ساماندهی به تفکرتان استفاده کنید، سپس بگذارید یک پزشک دارای مجوز تصمیم واقعی را بگیرد.