AIドクターの精度はどれくらい? 正直な数字
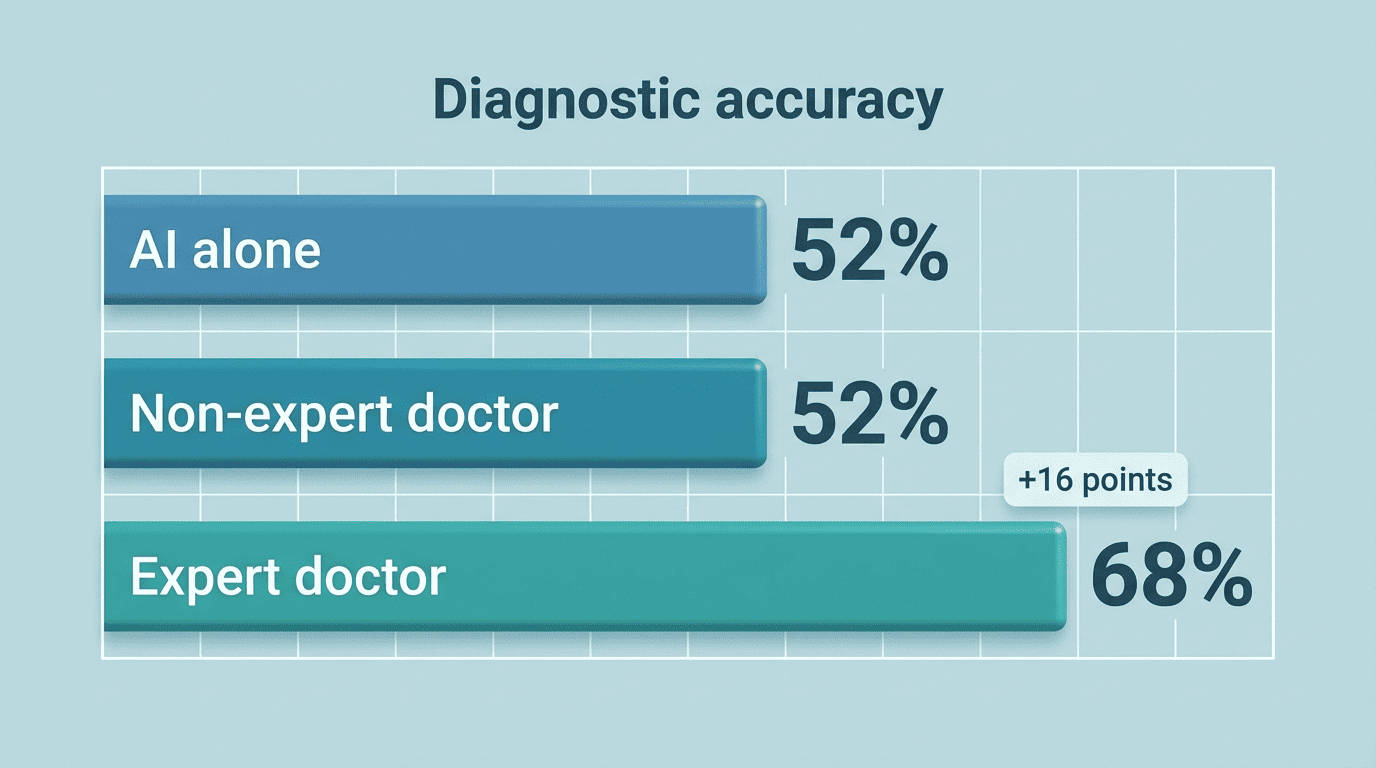
正直に言えば、AIドクターは一般的な症状については専門医ではない医師とほぼ同程度の精度がありますが、専門家には明らかに及びません。npj Digital Medicine に掲載された2025年の大規模メタ分析では、単独で用いた生成AIの診断精度は約52%とされています。オンラインのAIドクターは、確定的な判断ではなく、博識なセカンドオピニオンとして扱うのが最善です。
AIドクターは有資格の医師の代わりにはならず、診断を提供するものではありません。医療上の緊急時には119番(日本では救急)に電話してください。以下の精度の数字は、AIドクターが何に役立つのか、そしてどこでなお本物の医師が必要になるのかを正確に説明します。
手短な答え:AIドクターの本当の精度
マーケティングをはぎ取ってしまえば、話は単純です。生成AIの診断ツールは、単独で使うと、半分より少し多いくらいの割合で正解にたどり着きます。そしてこの一つの数字は、タスクや入力の質、比較相手によって生じる膨大なばらつきを覆い隠しています。
基準となる一つの数字:約52%
npj Digital Medicine に掲載された83件の研究を対象とする2025年の系統的レビューおよびメタ分析では、生成AIモデルが単独で動作するとき、全体の診断精度は52.1%(95%信頼区間 47.0〜57.1%)に達することがわかりました。低く聞こえますが、これは易しいケースと非常に難しいケースをまとめて平均した値であり、数字そのものよりもその背景にある文脈のほうが重要です。
本物の医師と比べると
同じメタ分析では、全体としてAIと医師の間に統計的に有意な差は見られず(p=0.10)、専門外の医師や研修医との間にも有意差はありませんでした(p=0.93)。しかしAIは専門医よりも有意に劣り、その差は約15.8パーセントポイントでした(p=0.007)。平たく言えば、AIの症状チェッカーは研修を終えたばかりの一般医と同程度で、長年のパターン認識を積んだ専門医には明らかに及びません。AIドクターと本物の医師を比較すると並べてみれば、ケースが難しくなるほどその差が広がっていくことがわかります。
なぜ精度の数字はこれほど大きく変動するのか
見出しを見比べる人は、まったく異なる数字に気づくでしょう。ある研究では97%、別の研究では40%。このばらつきの大部分は、見出しそのものではめったに触れられないいくつかの変数に起因します。
- 入力がどう集められたか — 構造化された臨床カルテか、患者本人の言葉か
- 「正解」が単一の最上位の答えを指すのか、上位3〜5個の候補のいずれかを指すのか
- その根底にある症状がどれほど一般的か、あるいはまれか
- どのモデル・バージョンが、いつテストされたか
- 研究が診断を測ったのか、トリアージを測ったのか、それとも両方か
ゴミを入れればゴミが出る:入力の質がすべて
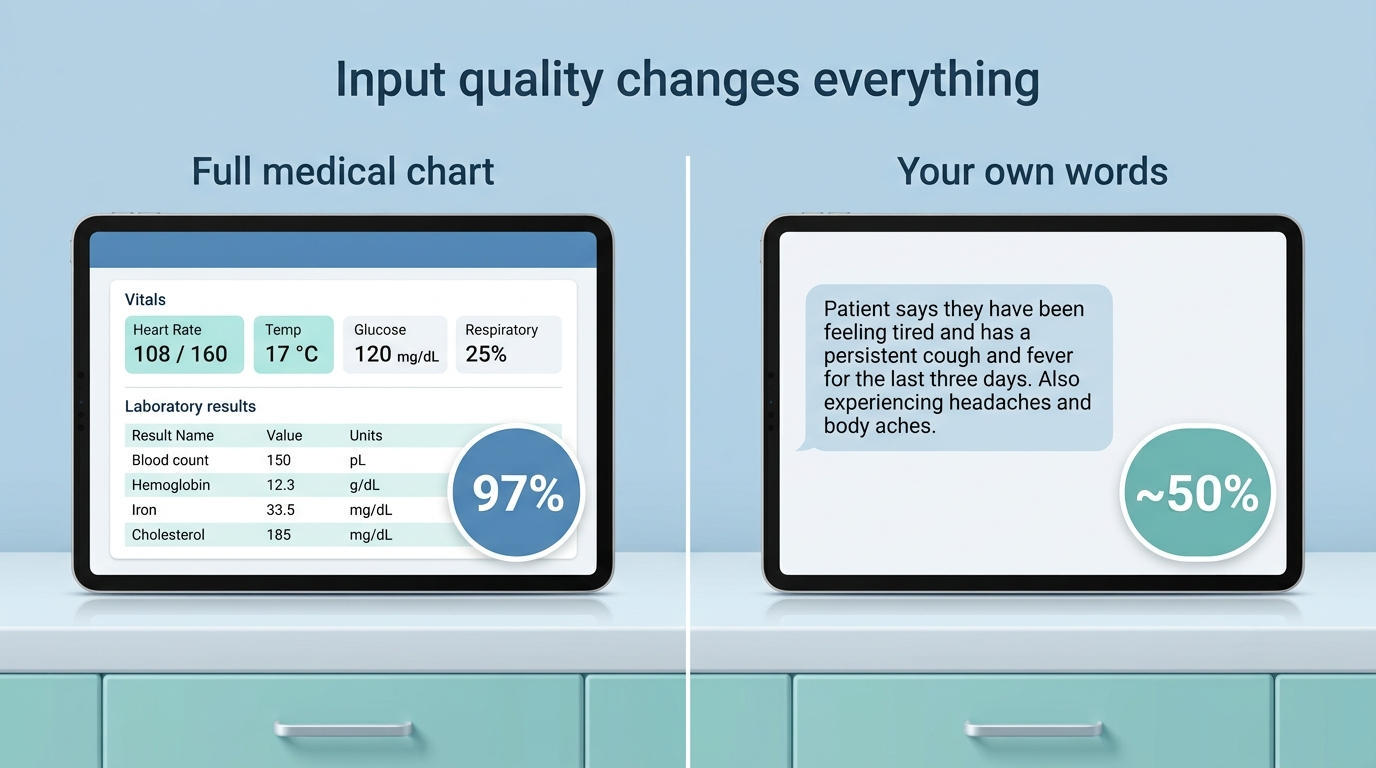
救急外来の患者100人を対象としたJMIRの研究では、GPT-4上で動作するChatGPTが97%の正解または部分的正解の診断に達しました。ただしそれは、治療にあたった医師が使ったのと同じ、バイタル・検査値・臨床メモを備えた医師によって整えられたカルテを与えられたからにすぎません。患者本人が申告した生の症状だけを与えられた場合、同種のモデルの精度は上位3件一致で約50%にまで下がります。AIの診断ツールは、あなたが伝えた内容の質までしか良くなりません。そしてAIドクターがどう機能するかを内部まで理解すれば、まったく同じモデルが入力の質だけでこれほど大きく振れる理由がわかります。
トップ1かトップ3か:引用されているのはどちらの数字?
「70〜80%の精度」という主張はたいてい、正解がAIのトリアージツールの上位3つの候補のどこかに現れることを意味し、正しい病名を最初に挙げたという意味ではありません。同じシステムに単一の答えを求めると、精度は34〜40%まで下がることがあります。どのAIヘルスアシスタントであれ精度の主張を目にしたら、それがトップ1なのかトップ3なのかを確認してください。両者はまったく別の約束であり、ベンダーはより見栄えのよいほうを前面に出しがちです。
| 測定方法 | 典型的な精度 | その意味 |
|---|---|---|
| トップ1(単一の最良の答え) | 34〜40% | 正しい診断が最初に挙げられ、代替案は示されない |
| トップ3(候補リストに正解が含まれる) | 70〜80% | 正しい病名が3つの候補の中に現れる |
| 医師が整えた入力(完全なカルテ) | 最大97% | 医師が使うのと同じ構造化データを与えた場合 |
| 患者の自己申告のみ | 約50%(トップ3) | 生の非構造化な症状の説明を与えた場合 |
AIドクターが正確な場面と、失敗する場面
診断精度は一つの技能ではなく複数の技能の集まりであり、AIドクターはそのうちのいくつかが得意でほかは苦手です。どれがどれかを知ることで、このツールの実際の使い方が変わります。
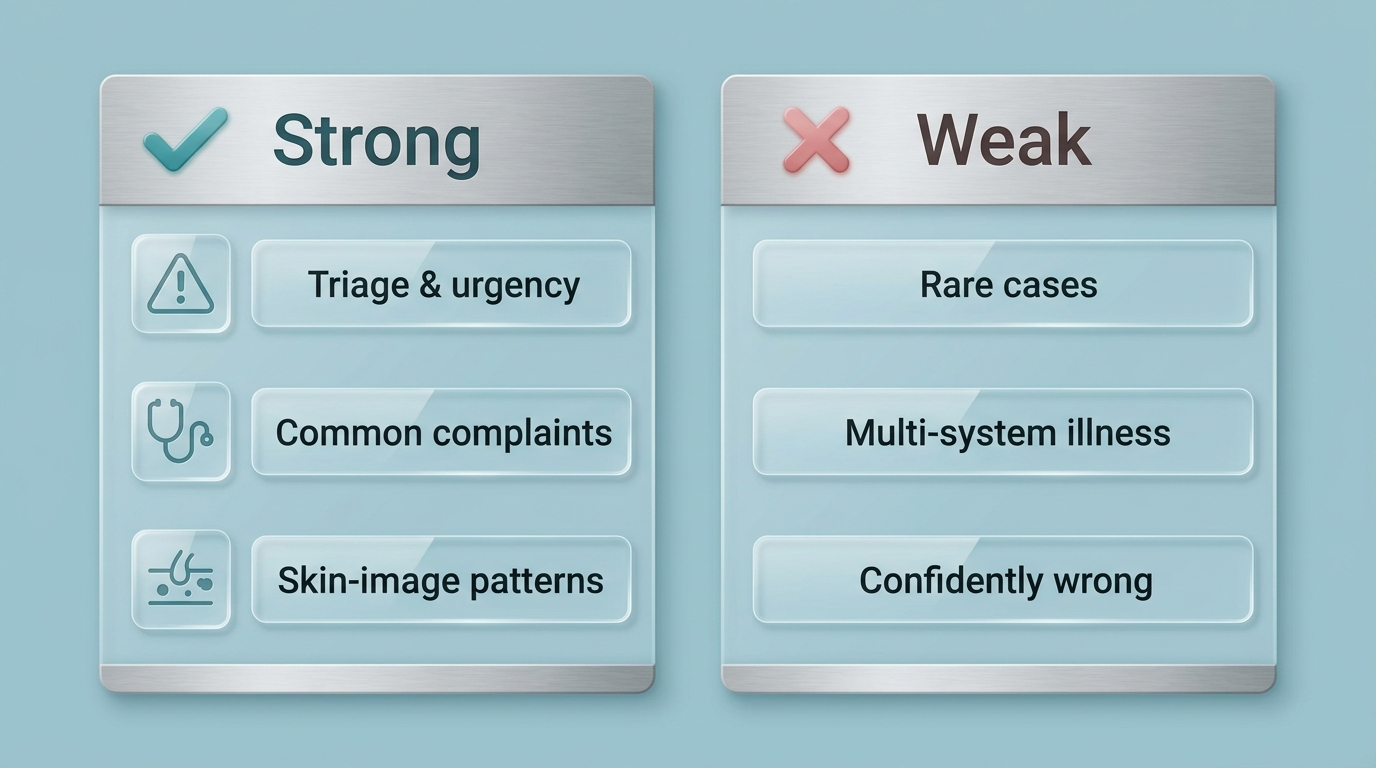
トリアージが得意。 AIドクターは、問いが「これはどのくらい何なのか」ではなく「これはどのくらい緊急か」であるときに最も信頼できます。症状を緊急・準緊急・通常に振り分けることは、最終診断に至ることよりも範囲が狭く定義の明確なタスクであり、モデルはより一貫してこれをこなす傾向があります。
一般的でよく記録された症状が得意。 分かりやすく、頻繁に見られる問題 — 豊富な学習データと明確な症状パターンを持つ類のもの — は、生成AI診断ツールの強みを生かします。
画像中心の狭い専門領域が得意。 皮膚科のようなパターン認識のタスクでは、メラノーマ検出に関する前向き研究のプール分析により、AI単独で感度約80.9%・特異度75.6%に達し、これは補助なしの皮膚科医に匹敵する水準で、AIが皮膚科医を置き換えるのではなく支援する場合には感度約91.9%・特異度83.7%まで上がることがわかりました。明確に定義された視覚的パターンの問題は、このツールの得意分野に近いのです。
複雑・まれ・多臓器にまたがるケースが苦手。 症状が複数の身体系統にまたがったり、まれな疾患を示唆したりすると、精度は急激に低下します。まさにここが、専門医の判断が最も重要になる場面です。
見落としやすい形の弱点:自信満々の誤り。 AIドクターは、疑いを示すそぶりもまったく見せず、流暢で安心させるような言葉で誤った診断を述べることがあります。もっともらしく聞こえる結果は、正しい結果と同じではありません。だからこそ人間による確認がなお重要なのです。
研究を信じてよいのか? 細かい注意書きを読もう
上記の心強い数字でさえ、それを評価する前に知っておくべき但し書きを伴っています。
83件のメタ分析では、83件中63件(76%)がバイアスのリスクが高いと評価され、著者らは統計的に有意な出版バイアス(p=0.045)を指摘しました。つまり、見栄えのよい結果が公表された文献の中で過剰に代表されている可能性が高いということです。世間の注目を集めた97%という救急外来の結果は、わずか100人の患者を対象とした単一の研究から出たもので、その知見が大規模でも成り立つことを確認する、事前に計画されたサンプルサイズ計算はありませんでした。
| 限界 | データが示すこと | それが重要な理由 |
|---|---|---|
| バイアスのリスク | 83件中63件(76%)が高リスクと評価 | 多くの結果は、実際の運用が生む結果よりも好意的である可能性がある |
| 出版バイアス | 統計的に有意(p=0.045) | 期待外れの結果を出した研究は公表されにくい |
| 小さなサンプル | 救急外来の研究は患者100人に基づく | 97%という数字が一般化することを確認する事前計画のサンプルサイズがない |
| 整えられた入力か生の入力か | 97%(整えられたカルテ)対 約50%(自己申告) | 同じモデルの精度が入力の質次第で約47ポイント振れる |
この一連の研究群には、いくつか繰り返し現れる欠落が見られます。
- ほとんどの研究は、雑然とした実世界の会話ではなく、文章ベースの症例シナリオでAIをテストしている
- AIが誤った答えを出した後に何が起こるか、すなわち下流の害を測る試験はほとんどない
- サンプルサイズは、見出しの数字が示す自信を裏づけるには小さすぎることが多い
- 元の研究チーム以外による独立した再現は、いまだにまれである
そのメタ分析の著者らは、自分たちの数字が何を意味するのかについて率直でした。
生成AIモデルは、まだ専門医の信頼できる代替とはなっていないが、専門家でない状況における有用な補助として、また医学研修者向けの教育ツールとして役立つ可能性がある。
npj Digital Medicine メタ分析、2025年
見出しの精度の数字は、保証ではなく楽観的な上限として扱ってください。小規模でバイアスのリスクが高い研究から引き出された数字は、あなた固有の症状に対して成り立つ数字とは同じではありません。
精度をふまえてAIドクターを安全に使う方法
上記の数字をふまえると、賢いやり方は、ツールができそうに聞こえることではなく、実際に得意なことに合わせて使うことです。
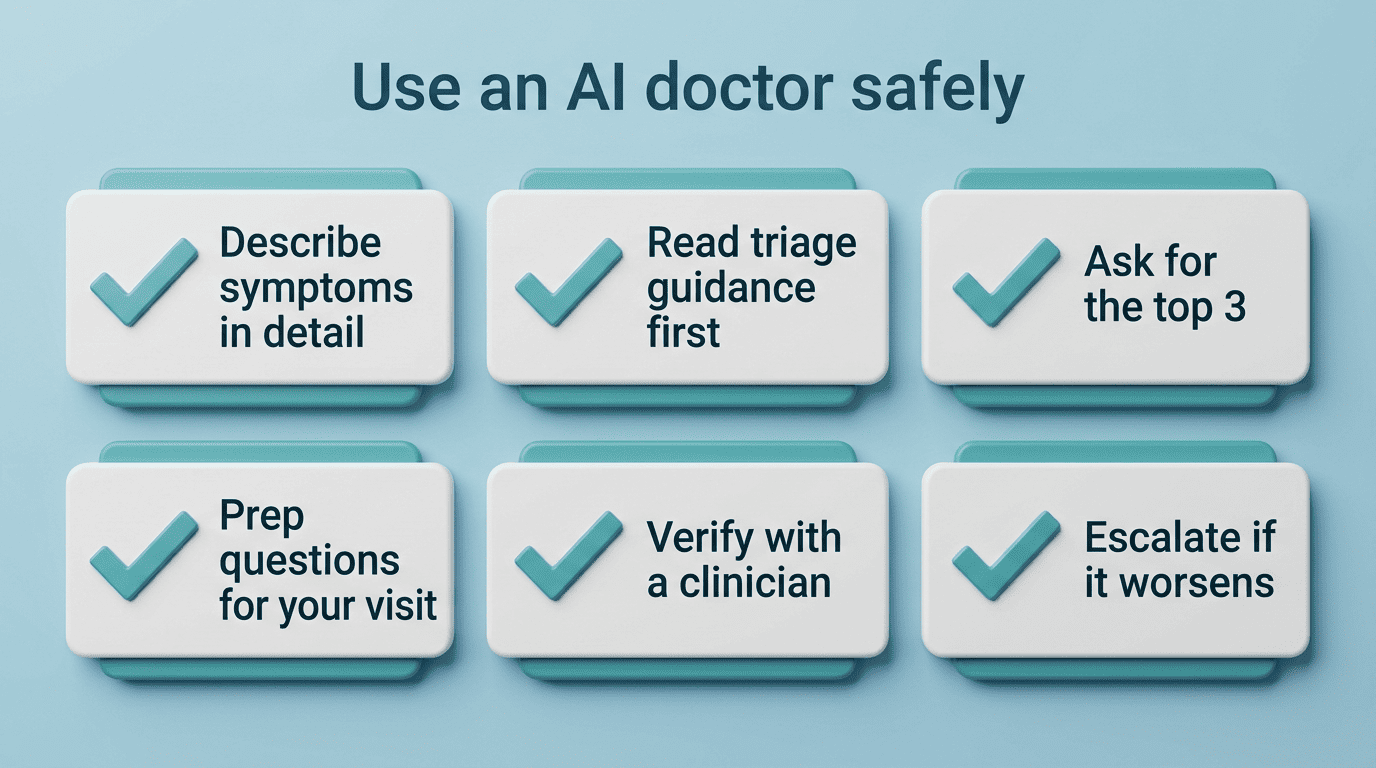
- 症状は略さず詳しく説明する。精度は入力の質に大きく左右されるので、持続期間・重症度・時間経過による変化を含めましょう。
- まずトリアージの案内を読む。緊急度の評価はAIの症状チェッカーが最も信頼できる部分です。緊急だと示されたら注意を払いましょう。
- トップ1だけでなくトップ3を求める。候補の一覧は、自信ありげな単一の答えよりも誠実です。
- 本物の診察に向けた質問の準備に使う。漠然とした不安を具体的な質問リストに変えることは、このツールの最も信頼できる使い方の一つです。
- 重要なことは何であれ有資格の臨床医に確認する。特に新しい・深刻な・持続する症状はそうしましょう。
- 症状が悪化したらすぐにエスカレーションする。AIが追いつくのを待たないこと。
- 単一のAIの答えを決して最終と見なさない。自分が実際にどう感じているか、そして専門家の助言と照らし合わせて確認しましょう。
AIの診断ツールは、特定の一連のタスクには最も役立ち、ほかには最も役立たない傾向があります。頼る前に、あなたの状況がその線のどちら側にあるのかを知っておくと役立ちます。
- 検査結果や紹介状に出てくる、なじみのない医学用語を理解する
- 新しい症状がどのくらい緊急かを見極める
- 医師の診察の前に、明確な質問リストを準備する
- すでに抱えている病気について、一般的な健康教育を得る
- 当日受診・予約受診・経過観察のいずれにするかを判断する
査読を経た合意は率直です。生成AIは、専門家でない状況における有用な補助であって、専門医の信頼できる代替ではありません。米国食品医薬品局(FDA)は、販売が認可されたAI搭載医療機器を追跡していますが、それはまさに、検証されていないAIの出力が現実の臨床リスクを伴うからです。研究者だけでなく規制当局も、この精度のギャップを重大なものとして扱っているという証左です。
AIを使わず本物の医師に診てもらうべきとき
AIドクターは有資格の医師の代わりにはならず、診断を提供するものではありません。医療上の緊急時には119番(日本では救急)に電話してください。
どんな精度のパーセンテージ — 52%でも、理想的な条件下での97%でも — も、深刻・突発的・悪化する症状に対してAIの診断ツールを頼りにしてよいとするものではありません。次のような症状の場合はAIを使わず、まっすぐ本物の医師または救急医療へ向かってください。
- 胸の痛みや圧迫感、または呼吸困難
- これまでに経験したことのない、突然の激しい頭痛
- 止まらない出血、または急速に悪化する外傷
- 脳卒中の兆候 — 顔のゆがみ、腕の脱力、ろれつが回らない
- とにかく緊急だと感じるあらゆる症状
AIヘルスアシスタントは自分の理解を深め、考えを整理するために使い、実際の判断は有資格の臨床医に委ねましょう。